Khi nào nên dùng noindex trên website chuẩn SEO?
Noindex nên được dùng khi một URL vẫn cần tồn tại cho người dùng, hệ thống hoặc luồng vận hành, nhưng không có giá trị để xuất hiện trên kết quả tìm kiếm. Đây là công cụ kiểm soát chỉ mục quan trọng trong SEO kỹ thuật, giúp loại bỏ trang trùng lặp, trang mỏng, trang chức năng, kết quả tìm kiếm nội bộ, filter/sort không có search intent, file PDF trùng nội dung hoặc tài nguyên không phục vụ người dùng từ SERP. Với trang HTML, cách triển khai phổ biến là meta robots noindex, follow để Google loại URL khỏi index nhưng vẫn có thể theo các liên kết nội bộ; với PDF, media, API hoặc file không phải HTML, nên dùng X-Robots-Tag ở cấp HTTP header. Điều quan trọng là không chặn robots.txt với những URL cần Google đọc thẻ noindex, vì bot phải crawl được trang mới xác nhận được directive.
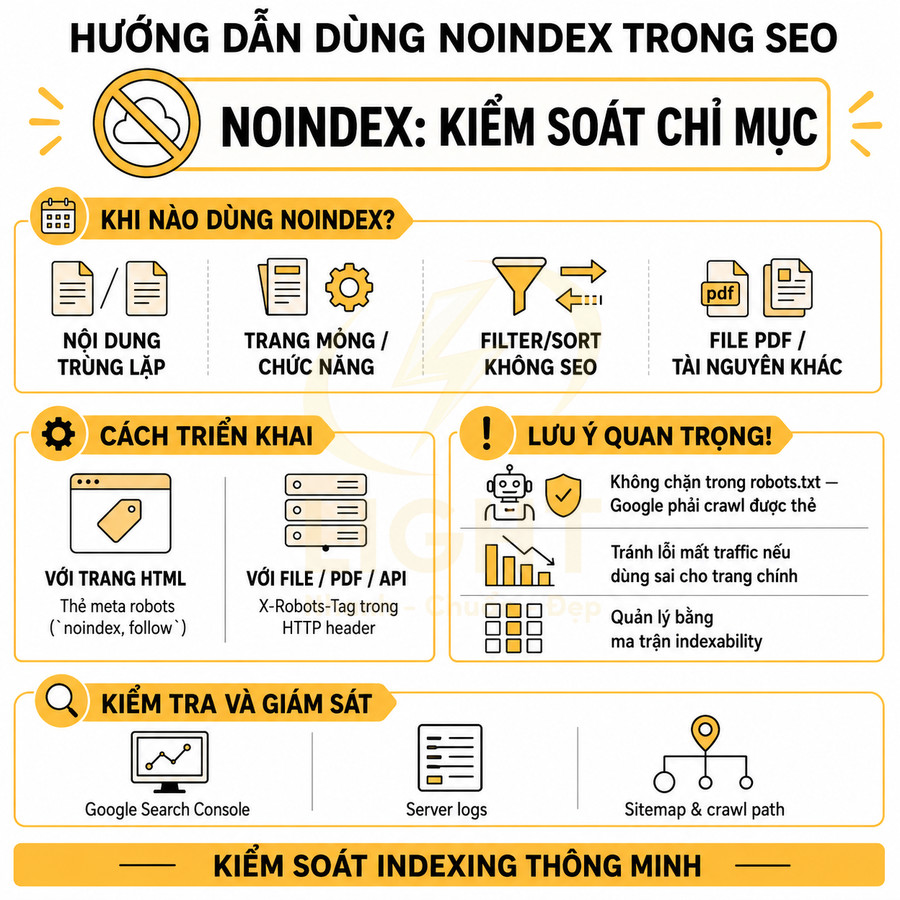
Noindex cũng cần được quản lý bằng ma trận indexability rõ ràng theo loại trang, intent, traffic, backlink, chuyển đổi và vai trò internal link. Dùng sai có thể khiến danh mục, sản phẩm, bài viết hoặc landing page quan trọng mất thứ hạng, làm nhiễu sitemap, giảm traffic long-tail và suy yếu crawl path. Vì vậy, trước và sau khi triển khai cần kiểm tra meta robots, canonical, status code, sitemap, log server, Google Search Console và traffic để đảm bảo chỉ những URL không nên index mới bị loại khỏi chỉ mục. Các thẻ canonical, meta robots và status code cần được kiểm tra đồng thời thay vì xử lý riêng lẻ. Trong thiết kế web chuẩn SEO, sự nhất quán giữa các tín hiệu này giúp công cụ tìm kiếm hiểu đúng trạng thái của URL, giảm nguy cơ index sai trang phụ, bỏ sót trang chính hoặc tạo ra vấn đề soft 404.
Cách triển khai noindex đúng kỹ thuật trên website chuẩn SEO
Triển khai noindex đúng kỹ thuật giúp kiểm soát chặt chẽ khả năng được lập chỉ mục của từng URL, tránh trùng lặp, lãng phí crawl budget và rò rỉ dữ liệu. Trên các trang HTML render được, cần ưu tiên thẻ meta robots với cấu hình phổ biến noindex, follow để vừa loại URL khỏi chỉ mục, vừa duy trì luồng internal link. Với tài nguyên không phải HTML như PDF, media, API, nên dùng X-Robots-Tag ở cấp HTTP header và xây dựng “ma trận indexability” cho từng loại file. Không nên chặn robots.txt với các URL cần Google đọc thẻ noindex; hãy phân biệt rõ mục tiêu “xóa khỏi chỉ mục” và “ngăn crawl”. Trên website dùng JavaScript, SSR hoặc CMS động, noindex phải được render ổn định trong HTML ban đầu, được thiết kế theo matrix rule và kiểm thử bằng crawler, Google Search Console trước khi áp dụng diện rộng. Noindex chỉ hoạt động ổn định khi cấu hình kỹ thuật được kiểm soát đồng bộ từ giao diện đến máy chủ. Trong thiết kế web, cần xác định rõ nơi sinh ra từng loại URL, cách CMS xuất thẻ meta robots và cách hệ thống xử lý header để tránh tình trạng trang quan trọng bị loại khỏi chỉ mục ngoài ý muốn.
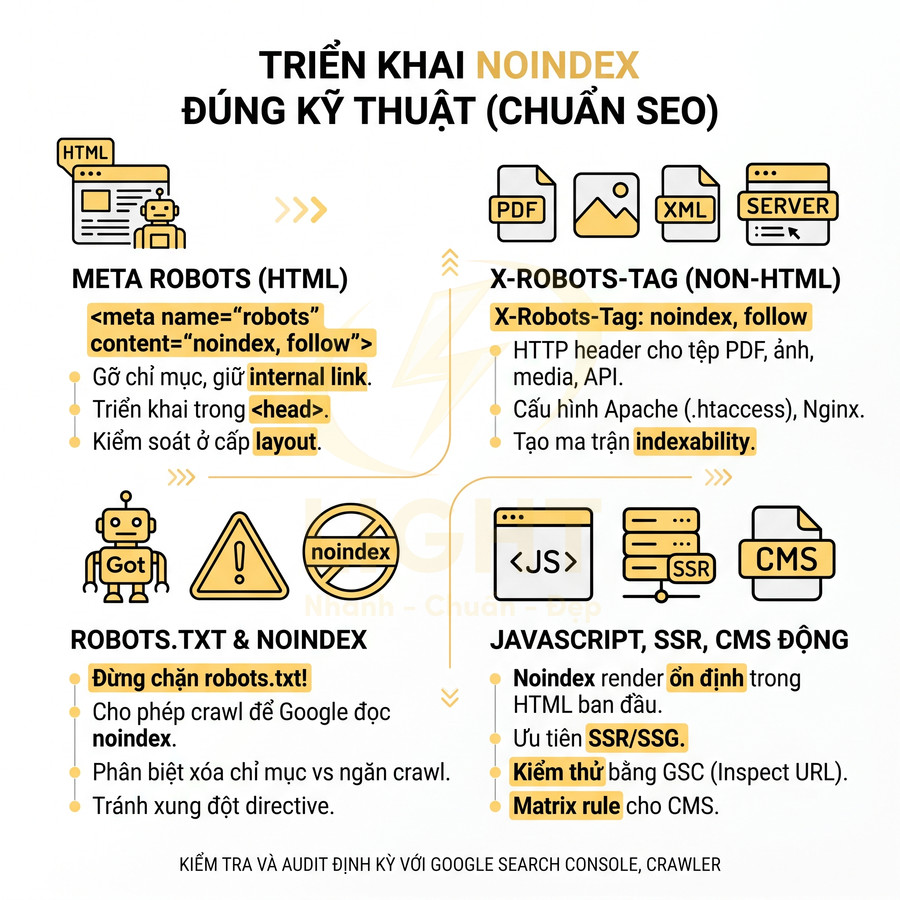
Dùng meta robots noindex trong HTML cho trang render được
Thẻ meta robots noindex là cơ chế điều khiển index trực tiếp ở cấp HTML, được Google và hầu hết công cụ tìm kiếm hỗ trợ chuẩn. Về mặt kỹ thuật, công cụ tìm kiếm sẽ:
- Crawl HTML của trang.
- Đọc các thẻ trong phần <head>, bao gồm
<meta name="robots">và các thẻ meta dành riêng cho từng bot (ví dụ:googlebot). - Ghi nhận directive noindex như một tín hiệu mạnh để loại URL khỏi chỉ mục trong các lần crawl tiếp theo.
Việc gắn noindex cần được xem là một quyết định quản trị vòng đời URL, không chỉ là thao tác kỹ thuật ngắn hạn. Một URL bị yêu cầu loại khỏi chỉ mục vẫn cần được crawler truy cập lại để cập nhật trạng thái, vì công cụ tìm kiếm vận hành theo cơ chế thu thập và làm mới dữ liệu có chọn lọc thay vì cập nhật toàn bộ web cùng lúc. Nghiên cứu về chính sách làm mới trang của crawler cho thấy tần suất tái thu thập thường được ưu tiên cho các URL có khả năng thay đổi hoặc có giá trị cao hơn. Vì vậy, không nên kỳ vọng URL biến mất ngay sau khi thêm noindex; cần duy trì trạng thái kỹ thuật ổn định, cho phép bot crawl và theo dõi bằng dữ liệu thực tế trong Google Search Console. Điều quan trọng là không thay đổi liên tục giữa index và noindex, vì tín hiệu thiếu nhất quán làm tăng thời gian kiểm chứng trạng thái của URL (Cho & Garcia-Molina, 2003).
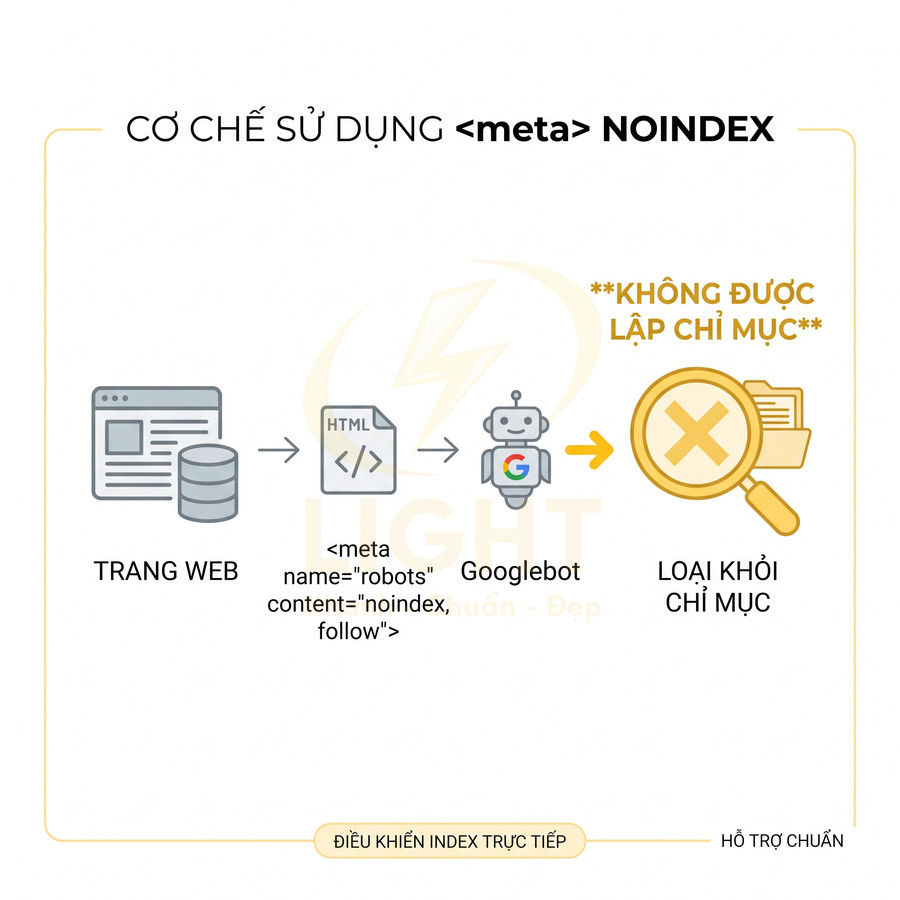
Cú pháp chuẩn và an toàn nhất cho đa số trường hợp:
<meta name="robots" content="noindex, follow">
Một số biến thể nâng cao:
<meta name="googlebot" content="noindex, follow">– áp dụng riêng cho Googlebot, hữu ích khi muốn xử lý khác nhau giữa Google và các bot khác.<meta name="robots" content="noindex, noarchive, follow">– vừa noindex, vừa chặn lưu bản cache (cache snippet) của trang.
Về mặt tín hiệu liên kết, noindex, follow là cấu hình quan trọng cho website chuẩn SEO vì:
- Cho phép Googlebot tiếp tục crawl các liên kết nội bộ trên trang, duy trì luồng PageRank và tín hiệu liên kết. Dù một trang không được đưa vào chỉ mục, các liên kết nằm trên trang vẫn có thể đóng vai trò hỗ trợ khám phá URL và thể hiện cấu trúc điều hướng của website. Tuy nhiên, không nên xây dựng kiến trúc internal link phụ thuộc quá nhiều vào các trang bị
noindexlâu dài, đặc biệt nếu đó là trang filter, archive sâu hoặc bước trung gian ít giá trị. Nghiên cứu về crawler tăng dần cho thấy crawler cần lựa chọn tài nguyên để tái truy cập dựa trên tính mới, chất lượng và mức độ hữu ích dự kiến của URL. Điều này hàm ý rằng các URL quan trọng như trang danh mục, bài trụ cột, sản phẩm chủ lực và landing page cần được liên kết trực tiếp từ những trang indexable, ổn định và có vị trí rõ trong cấu trúc website. Trangnoindex, follownên là lớp hỗ trợ điều hướng, không phải “trung tâm” duy nhất để bot phát hiện nội dung chiến lược (Cho & Garcia-Molina, 2000). - Giúp các trang noindex (ví dụ: filter, sort, bước trung gian) vẫn đóng vai trò “cầu nối” trong cấu trúc internal link.
- Giảm nguy cơ tạo ra “dead-end pages” khiến bot khó khám phá các URL sâu hơn.
Cần phân biệt rõ các giá trị phổ biến và tác động thực tế:
- noindex, follow: URL bị loại khỏi chỉ mục nhưng vẫn được crawl định kỳ để đọc link và cập nhật trạng thái noindex.
- noindex, nofollow: URL bị loại khỏi chỉ mục, bot được khuyến nghị không theo link; trong thực tế, Google có thể vẫn xử lý link ở mức độ hạn chế, nhưng không nên dựa vào điều này.
- index, follow: Trạng thái mặc định; chỉ nên khai báo khi cần override một rule khác (ví dụ: thẻ meta cấp trang ghi đè directive cấp thư mục hoặc cấp header).
Với website lớn, việc chuẩn hóa meta robots nên được thiết kế ở cấp kiến trúc thông tin:
- Nhóm các loại trang theo “mục tiêu SEO”: trang cần xếp hạng, trang hỗ trợ điều hướng, trang hệ thống.
- Gán rule cố định cho từng nhóm:
- Trang filter, sort, search result nội bộ: noindex, follow, có thể canonical về trang danh mục chính nếu phù hợp.
- Trang profile ẩn danh, trang bước giữa funnel (checkout step, confirm step): noindex, follow để vẫn truyền tín hiệu liên kết.
- Trang nội dung chính (category, product, article): index, follow.
- Triển khai rule ở cấp layout/template để mọi URL thuộc nhóm đó tự động nhận đúng meta robots.
Trong môi trường CMS (WordPress, Magento, Shopify, custom framework), nên:
- Định nghĩa rule noindex theo:
- Post type (product, page, post, custom type).
- Taxonomy (category, tag, brand).
- Template (search.php, archive.php, filter layout).
- Dùng plugin SEO chỉ như lớp cấu hình, nhưng luôn xác thực bằng:
- Xem source HTML (View Page Source) để chắc chắn thẻ meta nằm trong <head>.
- Dùng crawler (Screaming Frog, Sitebulb, JetOctopus) để xuất danh sách URL và trạng thái indexability.
Một số lỗi kỹ thuật nâng cao thường gặp:
- Trùng lặp directive:
- Nhiều thẻ
<meta name="robots">với giá trị khác nhau (index vs noindex). - Thẻ meta robots mâu thuẫn với X-Robots-Tag trong header.
- Plugin A đặt noindex, plugin B override lại index.
- Nhiều thẻ
- Thời điểm render thẻ meta:
- Noindex được chèn bằng JavaScript sau khi DOM load, trong khi HTML ban đầu không có thẻ này.
- Googlebot có thể chỉ dựa trên HTML trước render hoặc render không đầy đủ JS, dẫn đến noindex không được áp dụng ổn định.
- Vị trí sai trong DOM:
- Thẻ meta robots nằm trong
<body>hoặc được inject bởi script ở cuối trang. - Một số bot bỏ qua hoặc xử lý không nhất quán các thẻ meta ngoài
<head>.
- Thẻ meta robots nằm trong
Để kiểm soát chất lượng triển khai, nên thiết lập quy trình:
- Crawl toàn site định kỳ, lọc:
- URL có meta robots noindex.
- URL quan trọng nhưng bị noindex nhầm.
- URL cần noindex nhưng đang index, follow.
- Mapping các nhóm URL với chiến lược SEO đã định để phát hiện lệch chuẩn.
- Thiết lập cảnh báo nội bộ (QA checklist) mỗi khi tạo template mới hoặc post type mới.
Dùng X-Robots-Tag noindex cho PDF, file media và tài nguyên không phải HTML
X-Robots-Tag hoạt động ở cấp HTTP header, cho phép kiểm soát indexability của mọi loại tài nguyên có thể được crawl, không chỉ HTML. Về mặt kỹ thuật, khi bot gửi request, server trả về:
- Status code (200, 301, 404, 410, v.v.).
- Các header HTTP, trong đó có thể chứa X-Robots-Tag.
- Body (nội dung file: PDF, image, JSON, XML...).
Việc quyết định index hay noindex cho PDF, tài liệu tải xuống, tệp dữ liệu và tài nguyên kỹ thuật cần dựa trên giá trị độc lập của từng tài nguyên đối với người tìm kiếm. Một tài liệu PDF có nội dung chuyên sâu, cấu trúc rõ, được cập nhật và không có bản HTML tương đương có thể đáp ứng trực tiếp nhu cầu tra cứu; ngược lại, file chỉ lặp lại bài viết chính hoặc phục vụ quy trình nội bộ sẽ làm phân tán tín hiệu nội dung. Không nên noindex mọi PDF một cách máy móc. Cần đánh giá liệu URL đó có search intent riêng, nhận backlink, có khả năng được trích dẫn hoặc mang lại traffic chất lượng hay không. Các nghiên cứu về crawler hiện đại nhấn mạnh rằng web gồm nhiều loại tài nguyên, trạng thái HTTP và đường dẫn truy cập khác nhau; vì vậy, quản trị indexability theo “nhóm file” cần đi cùng ma trận mục đích sử dụng thay vì chỉ dựa vào phần mở rộng tệp (Chang et al., 2022).
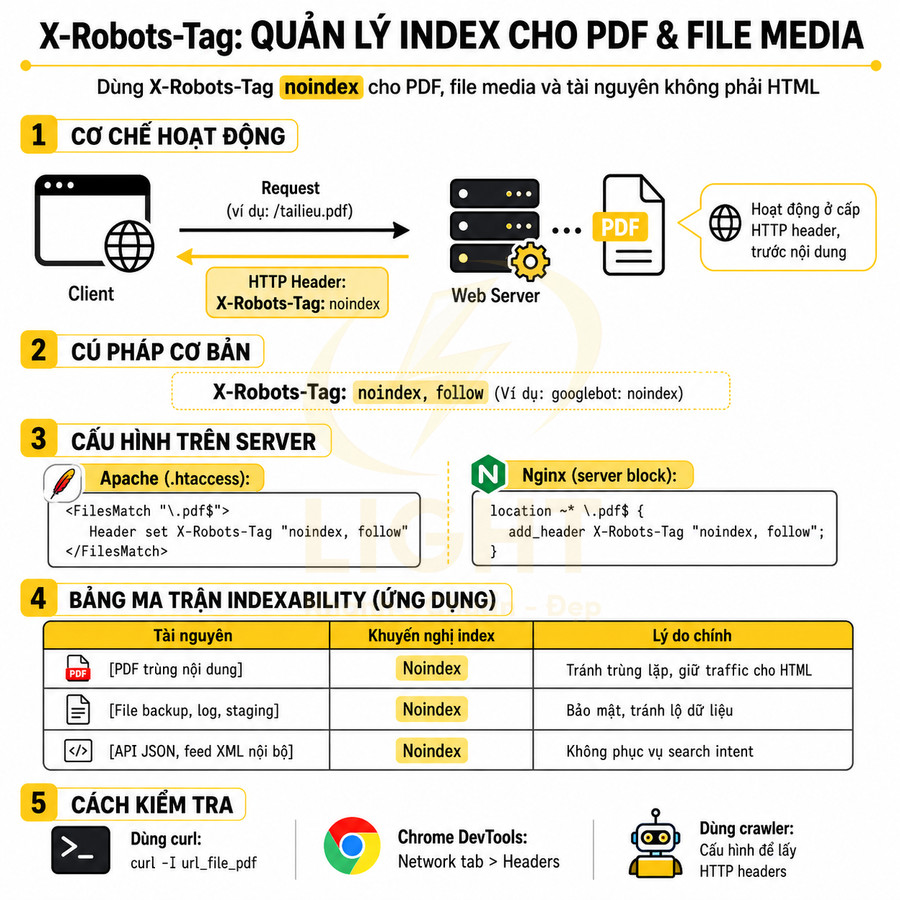
Nếu header chứa X-Robots-Tag: noindex, Google sẽ xử lý tương tự như meta robots noindex ở cấp HTML. Cú pháp cơ bản:
X-Robots-Tag: noindex, follow
Có thể target theo user-agent cụ thể:
X-Robots-Tag: googlebot: noindex
Trên Apache, cấu hình trong .htaccess hoặc VirtualHost cho từng pattern file:
<FilesMatch "\.pdf$">Header set X-Robots-Tag "noindex, follow"</FilesMatch>
Trên Nginx, cấu hình trong server block:
location ~* \.pdf$ {addheader X-Robots-Tag "noindex, follow";}
Một số pattern triển khai nâng cao:
- Noindex cho toàn bộ file trong thư mục backup:
- Apache:
<Location "/backup/">Header set X-Robots-Tag "noindex, nofollow"</Location> - Nginx:
location /backup/ {addheader X-Robots-Tag "noindex, nofollow";}
- Apache:
- Noindex cho mọi file trừ một số loại:
- Dùng rule mặc định noindex ở thư mục, sau đó override index cho các file cần index.
Việc dùng X-Robots-Tag đặc biệt quan trọng khi:
- Hệ thống có nhiều tài liệu tải về (PDF, DOC, PPT) trùng nội dung với bài viết HTML:
- Giữ traffic và tín hiệu SEO tập trung về URL HTML.
- Tránh phân tán anchor text và backlink vào nhiều URL tương đương.
- Có các file nhạy cảm hoặc tạm thời:
- Log, backup, export CSV, file staging.
- Không muốn xuất hiện trên SERP vì rủi ro bảo mật hoặc rò rỉ dữ liệu.
- Có API JSON, feed XML chỉ phục vụ ứng dụng:
- Không phù hợp với search intent của người dùng.
- Có thể gây duplicate hoặc index nội dung thô, khó hiểu.
Để quản lý nhất quán, nên xây dựng một “ma trận indexability” cho tài nguyên:
- Liệt kê loại file (PDF, image, video, JSON, XML, log...).
- Đánh dấu:
- Được index (phục vụ SEO, có nội dung hữu ích, có thể xếp hạng).
- Noindex (trùng lặp, kỹ thuật, nhạy cảm, không phục vụ người dùng).
- Mapping ma trận này vào cấu hình Apache/Nginx hoặc layer ứng dụng (middleware) để set header tự động.
| Loại tài nguyên | Khuyến nghị index | Cách triển khai | Lý do chính |
|---|---|---|---|
| PDF trùng nội dung với bài viết HTML | Noindex | X-Robots-Tag: noindex, follow | Tránh duplicate, giữ tín hiệu SEO cho URL HTML chính |
| PDF tài liệu chuyên sâu không có bản HTML | Index | Không đặt X-Robots-Tag hoặc để index, follow | Tận dụng traffic từ tìm kiếm tài liệu chuyên ngành |
| File media tạm, file log, backup | Noindex | X-Robots-Tag: noindex, nofollow | Tránh lộ dữ liệu, không cần xuất hiện trên SERP |
| API JSON, feed XML nội bộ | Noindex | X-Robots-Tag: noindex | Không phục vụ search intent của người dùng |
Sau khi cấu hình, cần kiểm tra thực tế:
- Dùng curl:
curl -I https://example.com/file.pdfđể xem header trả về có X-Robots-Tag hay không.
- Dùng Chrome DevTools:
- Tab Network > chọn request > tab Headers > kiểm tra Response Headers.
- Dùng crawler:
- Cấu hình để thu thập HTTP header, lọc theo X-Robots-Tag.
Không chặn robots.txt URL đang cần Google nhìn thấy thẻ noindex
Khi một URL bị Disallow trong robots.txt, Googlebot sẽ:
- Không crawl nội dung trang.
- Không đọc được thẻ meta robots noindex hoặc X-Robots-Tag trong header.
- Vẫn có thể giữ URL trong chỉ mục nếu đã biết từ trước (qua link, sitemap, dữ liệu cũ), nhưng chỉ hiển thị rất ít thông tin (thường chỉ URL, không snippet).
robots.txt và noindex giải quyết hai mục tiêu khác nhau: một bên định hướng quyền truy cập của crawler, bên còn lại truyền đạt ý định không xuất hiện trong chỉ mục. Khi cần loại một URL công khai khỏi kết quả tìm kiếm, trang phải còn khả năng được bot truy cập để đọc directive và xác nhận trạng thái. Nếu URL bị chặn hoàn toàn trước khi bot thấy được nội dung hoặc header, hệ thống không có cơ sở mới để cập nhật yêu cầu loại bỏ. Cần tách rõ “không muốn bot crawl” với “không muốn URL xuất hiện trên SERP”. Các nghiên cứu về robots exclusion cho thấy tệp robots.txt là cơ chế kiểm soát đường đi của crawler, không phải công cụ thay thế cho quản trị nội dung đã được index. Với khu vực nhạy cảm, lớp bảo vệ đúng phải là xác thực, phân quyền hoặc hạn chế truy cập máy chủ; noindex và robots.txt không phải biện pháp bảo mật dữ liệu (Vyas et al., 2023).
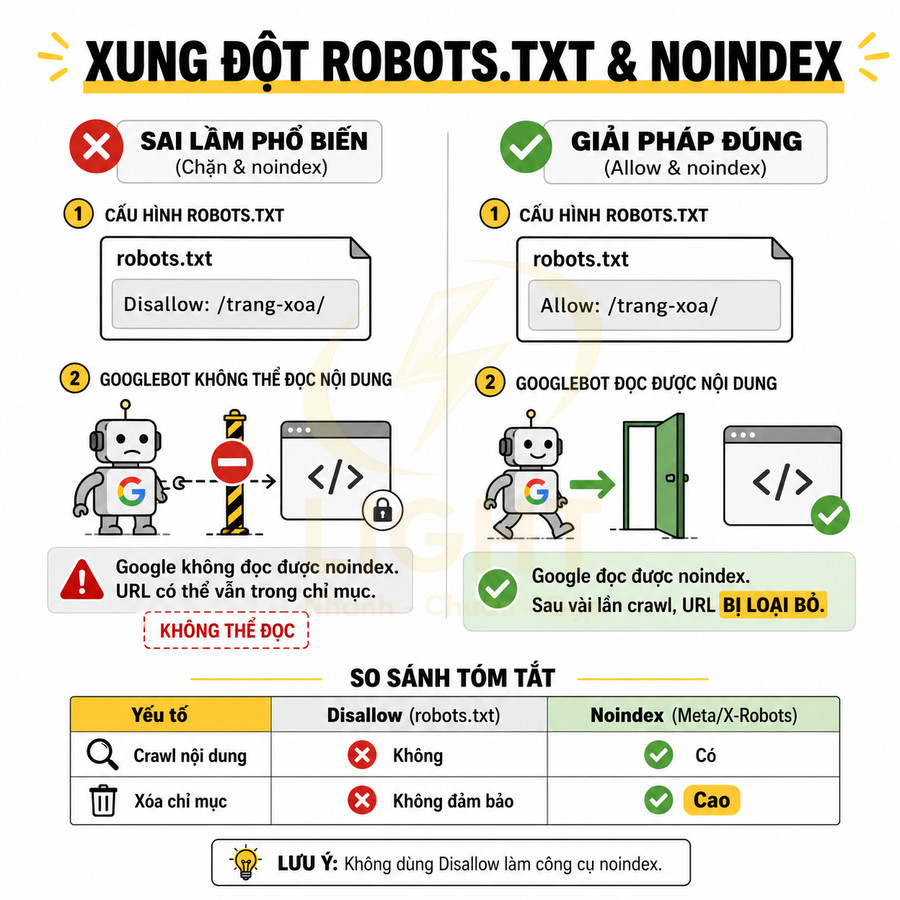
Do đó, nếu mục tiêu là loại URL khỏi chỉ mục, cần:
- Cho phép crawl URL đó (không Disallow trong robots.txt).
- Đặt noindex bằng meta robots hoặc X-Robots-Tag.
- Đợi vài lần crawl để Google cập nhật trạng thái và loại khỏi chỉ mục.
Ngược lại, nếu mục tiêu là ngăn crawl vì lý do tài nguyên hoặc bảo mật, robots.txt là công cụ phù hợp, nhưng:
- Không đảm bảo URL sẽ biến mất khỏi chỉ mục nếu đã được biết đến.
- Chỉ đảm bảo Google không truy cập nội dung để đọc thêm dữ liệu.
Một số pattern triển khai hợp lý trên website chuẩn SEO:
- /filter/:
- Cho phép crawl.
- Dùng meta robots noindex, follow để tránh index các biến thể filter nhưng vẫn truyền tín hiệu liên kết.
- /admin/, /private/:
- Disallow trong robots.txt.
- Có thể kết hợp bảo vệ bằng auth, IP whitelist, hoặc noindex ở cấp header nếu vẫn có khả năng bị truy cập công khai.
- /search/:
- Cho phép crawl.
- Dùng noindex cho trang kết quả tìm kiếm nội bộ để tránh index các query noise, thin content.
| Yếu tố | robots.txt Disallow | Meta/X-Robots-Tag noindex |
|---|---|---|
| Khả năng crawl nội dung | Không (bị chặn) | Có (để đọc thẻ noindex) |
| Khả năng xóa khỏi chỉ mục | Không đảm bảo, nhất là URL đã index | Cao, Google sẽ loại khỏi chỉ mục sau vài lần crawl |
| Hiển thị snippet nội dung | Không có snippet, có thể chỉ hiển thị URL | Không hiển thị vì không còn trong chỉ mục |
| Truyền tín hiệu liên kết | Không crawl nên không truyền | Có thể truyền nếu dùng noindex, follow |
Để tránh xung đột giữa robots.txt và noindex:
- Audit robots.txt định kỳ:
- Liệt kê các pattern Disallow.
- So sánh với danh sách URL đang noindex (từ crawler hoặc log).
- Khi phát hiện URL vừa Disallow vừa noindex:
- Quyết định mục tiêu chính: ưu tiên xóa khỏi chỉ mục (bỏ Disallow, giữ noindex) hay ưu tiên chặn crawl (giữ Disallow, chấp nhận có thể vẫn còn trong chỉ mục dạng hạn chế).
- Tránh dùng Disallow như một “công cụ noindex”, vì đây là hai lớp tín hiệu khác nhau.
Đảm bảo noindex được render đúng trên website JavaScript, SSR và CMS động
Với website dùng JavaScript framework (React, Vue, Angular, Next.js, Nuxt, v.v.) hoặc CMS động, thách thức lớn nằm ở việc Googlebot có thực sự nhìn thấy thẻ noindex trong phiên bản HTML mà nó xử lý hay không. Về mặt kỹ thuật, Google có hai giai đoạn:
- Crawl HTML ban đầu (initial HTML).
- Xếp hàng để render JavaScript (rendering queue), có thể trễ hơn.
Nếu noindex chỉ xuất hiện sau khi JS chạy ở client, có nguy cơ:
- Google chỉ dựa trên HTML ban đầu không có noindex.
- Trạng thái index của URL không ổn định, đặc biệt với site lớn hoặc JS nặng.
Với website JavaScript, vấn đề không chỉ là thẻ robots có xuất hiện trong DOM sau khi trang hoàn tất tải, mà là nó có xuất hiện trong phiên bản HTML và trạng thái render mà crawler thực sự xử lý hay không. Nghiên cứu về crawling ứng dụng AJAX cho thấy các website động có thể tạo nhiều trạng thái giao diện, đường dẫn và nội dung thay đổi theo tương tác; crawler cần tái dựng trạng thái để hiểu đầy đủ cấu trúc ứng dụng. Vì vậy, việc chỉ kiểm tra bằng “Inspect Element” trên trình duyệt là chưa đủ. Với các URL cần kiểm soát indexability, thẻ noindex nên được xuất ngay ở lớp render đầu tiên, ưu tiên SSR, SSG hoặc middleware server-side. Không nên để client-side JavaScript quyết định độc lập trạng thái index, vì lỗi tải script, cache, hydration hoặc điều kiện hiển thị có thể tạo ra tín hiệu không nhất quán giữa các lần crawl (Mesbah, van Deursen, & Lenselink, 2012).
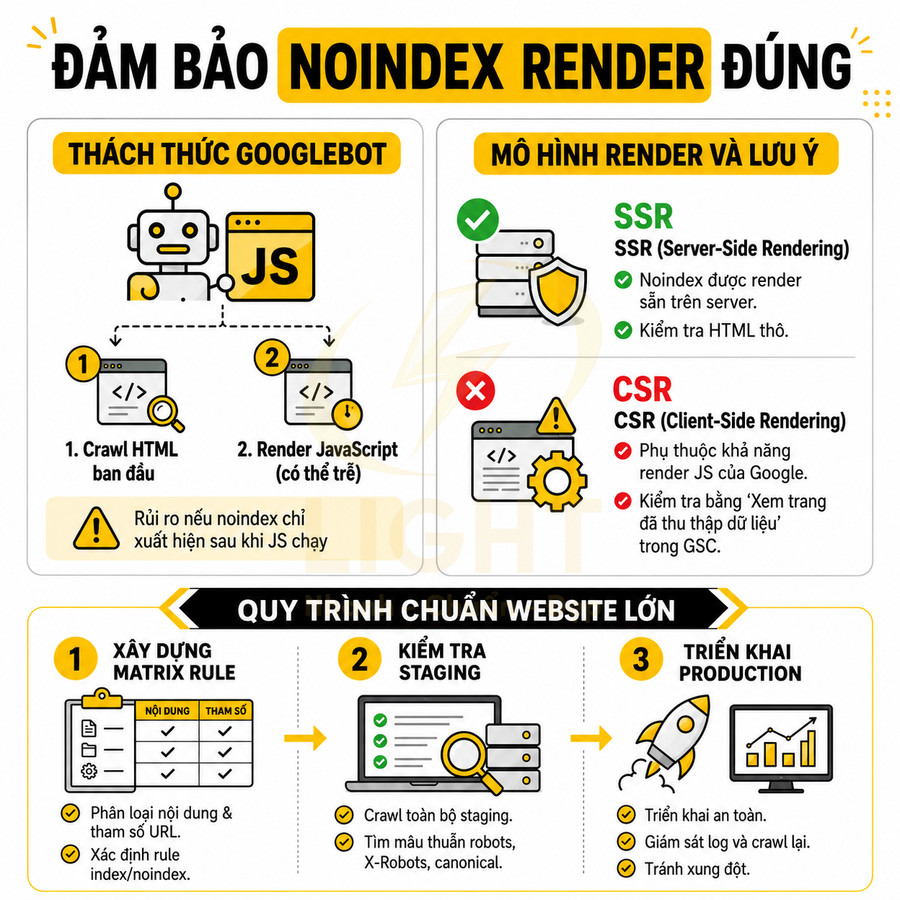
Các mô hình render và lưu ý triển khai:
- SSR (Server-Side Rendering):
- Thẻ meta robots phải được render sẵn trên server.
- Kiểm tra bằng “View Page Source” (HTML thô), không chỉ dựa vào “Inspect Element” (DOM sau render).
- Trong Next.js/Nuxt, logic noindex nên nằm trong component layout hoặc middleware SSR, không chỉ trong hook client-side.
- CSR (Client-Side Rendering):
- Rủi ro cao hơn vì phụ thuộc vào khả năng render JS của Google.
- Bắt buộc test bằng “URL Inspection > View Crawled Page” trong GSC để xem phiên bản Google nhận được có thẻ noindex hay không.
- Nếu có thể, nên chuyển các trang quan trọng sang SSR/SSG để kiểm soát tốt hơn.
- Hybrid (SSR + CSR, ISR, SSG):
- Logic noindex phải được áp dụng ở layer render đầu tiên (SSR/SSG/ISR).
- Tránh trường hợp SSR trả về index, client-side JS đổi thành noindex hoặc ngược lại, gây tín hiệu mâu thuẫn.
Trong CMS động, rule noindex thường phụ thuộc nhiều điều kiện:
- Loại nội dung:
- Product hết hàng (out-of-stock) nhưng vẫn muốn giữ index để nhận traffic.
- Trang event đã hết hạn, cần noindex hoặc canonical về trang event list.
- Trang tag mỏng nội dung, cần noindex để tránh thin content.
- Trạng thái nội dung:
- Draft/private: thường chặn truy cập bằng auth, không cần noindex.
- Expired: có thể noindex hoặc 410 tùy chiến lược.
- Tham số URL:
?utm=,?ref=: thường canonical về URL sạch, không nhất thiết noindex.?sort=,?filter=,?page=: có thể noindex, follow hoặc canonical về trang chính.
Để giảm rủi ro, nên xây dựng:
- Matrix rule rõ ràng:
- Trục 1: Loại trang (home, category, product, article, search, filter, profile...).
- Trục 2: Trạng thái (active, expired, out-of-stock, private...).
- Trục 3: Tham số (clean URL, có filter, có tracking...).
- Mỗi ô trong matrix xác định: index/noindex, follow/nofollow, canonical về đâu.
- Quy trình test:
- Chọn một số URL đại diện cho từng loại.
- Xem source HTML để kiểm tra meta robots.
- Dùng “Inspect URL” trong GSC để xem Google thấy gì.
- Dùng crawler có khả năng render JS để mô phỏng Googlebot hiện đại.
- Kiểm soát xung đột:
- Đảm bảo chỉ có một nguồn quyết định meta robots (core, plugin SEO, middleware), tránh override lẫn nhau.
- Log lại các rule áp dụng cho từng request (debug mode) trên môi trường staging để QA dễ kiểm tra.
Với website chuẩn SEO quy mô lớn, môi trường staging là bắt buộc cho các thay đổi liên quan đến indexability:
- Triển khai rule noindex mới trên staging.
- Crawl toàn bộ staging để kiểm tra:
- Những nhóm URL nào đang noindex.
- Có trang quan trọng nào bị noindex nhầm không.
- Có mâu thuẫn giữa meta robots, X-Robots-Tag và canonical không.
- Sau khi xác nhận, mới deploy sang production, kết hợp monitoring log và crawl lại một phần site để đảm bảo không phát sinh lỗi ngoài dự kiến.
Rủi ro SEO khi dùng noindex sai cách
Noindex nếu dùng sai cách có thể trở thành “công tắc tự hủy” cho hiệu suất SEO tổng thể. Vấn đề không chỉ nằm ở việc một vài URL bị loại khỏi chỉ mục, mà là chuỗi hệ quả lan rộng: mất thứ hạng, đứt gãy cấu trúc internal link, lãng phí crawl budget và làm nhiễu toàn bộ bức tranh indexability. Đặc biệt nguy hiểm khi noindex chạm vào các nhóm trang đang tạo traffic, chuyển đổi, backlink hoặc đóng vai trò hub phân phối PageRank. Bên cạnh đó, việc để URL noindex trong sitemap, noindex hàng loạt mà không phân tích long-tail, hay phụ thuộc vào các hub noindex để điều hướng đều có thể khiến website suy yếu dần mà khó nhận ra. Vì vậy, noindex cần được xem như một công cụ chiến lược, phải có quy trình kiểm soát, dữ liệu hỗ trợ và cơ chế giám sát liên tục.
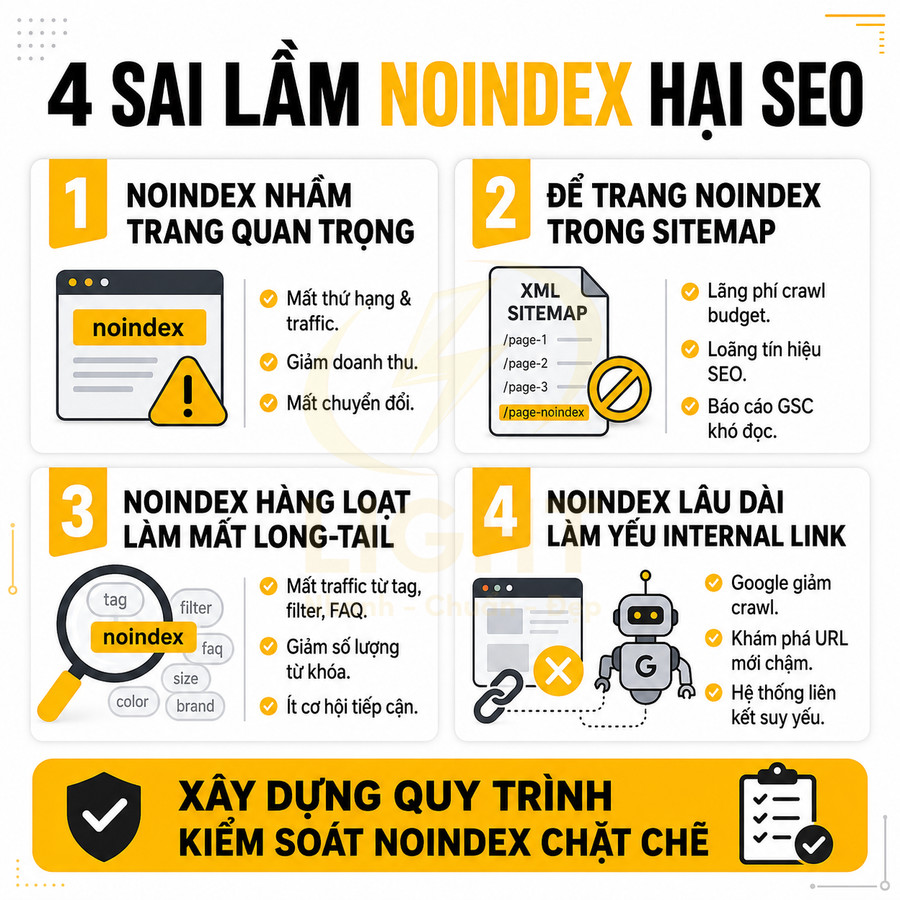
Noindex nhầm trang danh mục, sản phẩm, bài viết hoặc landing page có traffic
Noindex là một tín hiệu cực kỳ mạnh đối với Googlebot. Khi một URL được gắn thẻ meta robots noindex hoặc x-robots-tag: noindex, Google sẽ dần loại bỏ trang đó khỏi chỉ mục. Nếu áp dụng nhầm cho các trang đang mang lại traffic, chuyển đổi, backlink hoặc đóng vai trò hub internal link, tác động tiêu cực có thể kéo dài nhiều tháng, thậm chí khó phục hồi hoàn toàn.
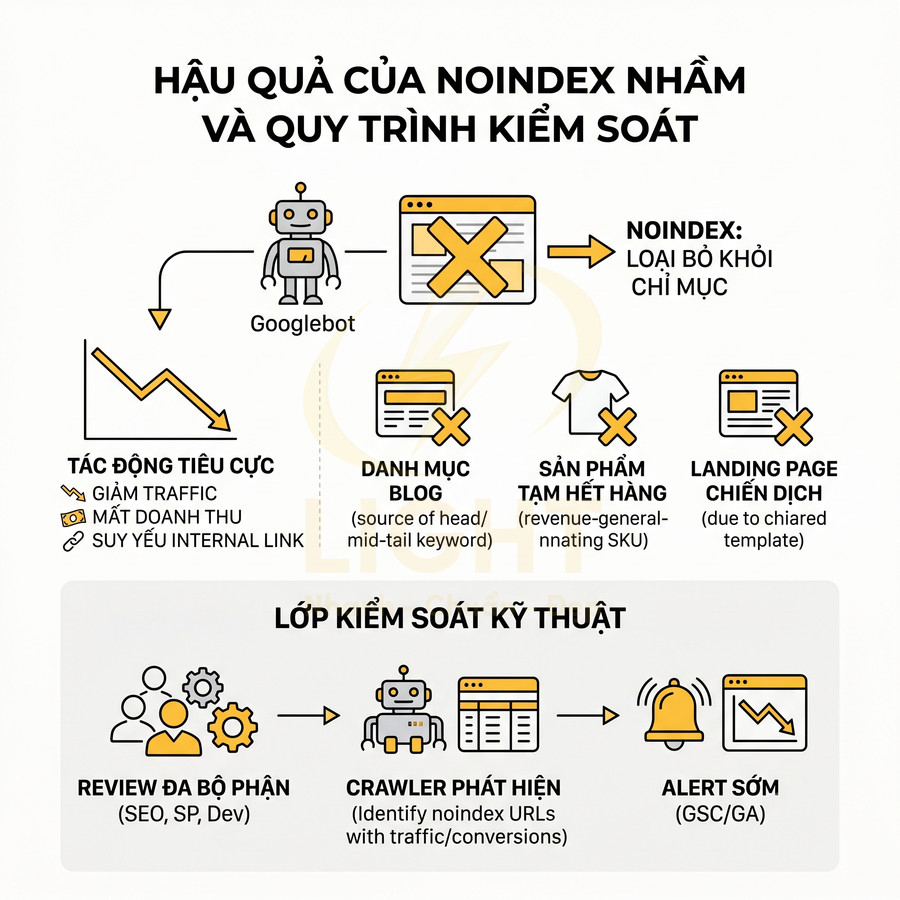
Về mặt kỹ thuật, khi một trang bị noindex trong thời gian đủ lâu:
- URL sẽ bị loại khỏi chỉ mục, mất toàn bộ thứ hạng đã tích lũy.
- Các tín hiệu liên quan đến URL đó (CTR, historical performance, topical relevance) có thể bị “đóng băng” hoặc suy yếu.
- Nếu trang là một node quan trọng trong cấu trúc internal link, việc mất nó khỏi chỉ mục có thể làm đứt gãy dòng PageRank nội bộ, khiến nhiều URL con bị giảm sức mạnh.
Các tình huống sai sót thường gặp trong thực tế triển khai:
- Noindex nhầm category blog đang là landing page chính cho nhiều từ khóa thông tin:
- Category thường được tối ưu để rank cho các từ khóa “head” hoặc “mid-tail” (ví dụ: “hướng dẫn SEO”, “áo thun nam”).
- Khi category bị noindex, Google có thể chuyển traffic sang các bài viết lẻ, nhưng tổng traffic thường giảm vì mất một trang tổng hợp có authority cao.
- Các bài viết con cũng mất một nguồn internal link mạnh, làm suy yếu khả năng xếp hạng.
- Noindex nhầm trang sản phẩm có doanh thu cao khi cấu hình rule “out-of-stock = noindex”:
- Không phân biệt giữa sản phẩm tạm hết hàng (còn bán lại) và sản phẩm ngừng kinh doanh vĩnh viễn.
- Với sản phẩm tạm hết hàng, tốt hơn nên:
- Giữ index, hiển thị trạng thái hết hàng và gợi ý sản phẩm thay thế.
- Hoặc dùng structured data phù hợp (ví dụ: availability) thay vì noindex.
- Noindex nhầm có thể làm mất toàn bộ traffic organic và doanh thu gắn với SKU đó, đồng thời làm yếu đi các internal link từ sản phẩm sang category, bài blog, v.v.
- Noindex nhầm landing page chiến dịch đang chạy quảng cáo và có organic traffic:
- Thường xảy ra khi dùng chung template với trang test A/B hoặc staging, rồi gắn noindex ở template mà không override cho trang live.
- Hậu quả:
- Traffic organic giảm mạnh, dữ liệu attribution bị méo vì mất kênh Organic.
- Chất lượng chiến dịch quảng cáo bị ảnh hưởng nếu landing page mất trust từ Google Ads (Quality Score gián tiếp bị tác động).
Để giảm rủi ro, cần xây dựng quy trình và lớp kiểm soát kỹ thuật:
- Thiết lập quy trình review đa bộ phận trước khi áp dụng noindex hàng loạt:
- SEO chịu trách nhiệm đánh giá tác động đến indexability, traffic, keyword portfolio.
- Product/Business đánh giá tác động đến funnel, conversion, revenue.
- Dev đảm bảo logic triển khai chính xác, có cơ chế rollback nhanh.
- Dùng crawler (Screaming Frog, Sitebulb, custom crawler) để:
- Liệt kê toàn bộ URL có meta robots noindex hoặc x-robots-tag noindex.
- Join với dữ liệu traffic, conversion, backlink từ GA/GSC và tool off-page:
- Phát hiện URL noindex nhưng có session, revenue, hoặc nhiều referring domains.
- Ưu tiên kiểm tra các URL có vai trò hub (nhiều internal inlink/outlink).
- Thiết lập alert sớm:
- Trong GSC: theo dõi nhóm URL quan trọng bằng regex hoặc folder structure, khi impression/click giảm bất thường cần kiểm tra khả năng noindex.
- Trong analytics: tạo segment cho nhóm trang chiến lược, set alert khi traffic giảm vượt ngưỡng (ví dụ >30% trong 24–48h).
- Trong hệ thống CI/CD: log mọi thay đổi liên quan đến meta robots, header x-robots-tag để có thể audit khi sự cố xảy ra.
Để URL noindex trong sitemap làm nhiễu tín hiệu indexability
Sitemap XML là một trong những tín hiệu quan trọng giúp Google hiểu tập URL mà bạn chủ động đề xuất được index. Khi vẫn để các URL noindex trong sitemap, bạn đang tạo ra một mâu thuẫn trực tiếp:
- Sitemap: “URL này quan trọng, hãy crawl và index”.
- Meta robots / x-robots-tag: “Đừng index URL này”.
Sitemap nên được xem là tập URL mà website chủ động đề xuất để crawler ưu tiên khám phá và đánh giá cho chỉ mục. Khi một URL vừa nằm trong sitemap vừa mang noindex, website đang duy trì hai tín hiệu vận hành trái ngược: một tín hiệu yêu cầu crawler tiếp tục chú ý đến URL, tín hiệu còn lại yêu cầu không đưa URL vào kết quả tìm kiếm. Dù tình trạng này không mặc nhiên gây án phạt, nó làm giảm khả năng đọc dữ liệu audit một cách rõ ràng, đặc biệt trên website có hàng chục nghìn URL. Nghiên cứu về crawler tăng dần cho thấy việc phân bổ tài nguyên crawl luôn là bài toán lựa chọn giữa nhiều URL có giá trị không đồng đều. Vì vậy, sitemap nên ưu tiên các URL trả về 200, có canonical hợp lệ, không bị chặn crawl và thực sự có mục tiêu xếp hạng, thay vì trở thành danh sách tổng hợp mọi URL tồn tại trong hệ thống (Cho & Garcia-Molina, 2000).
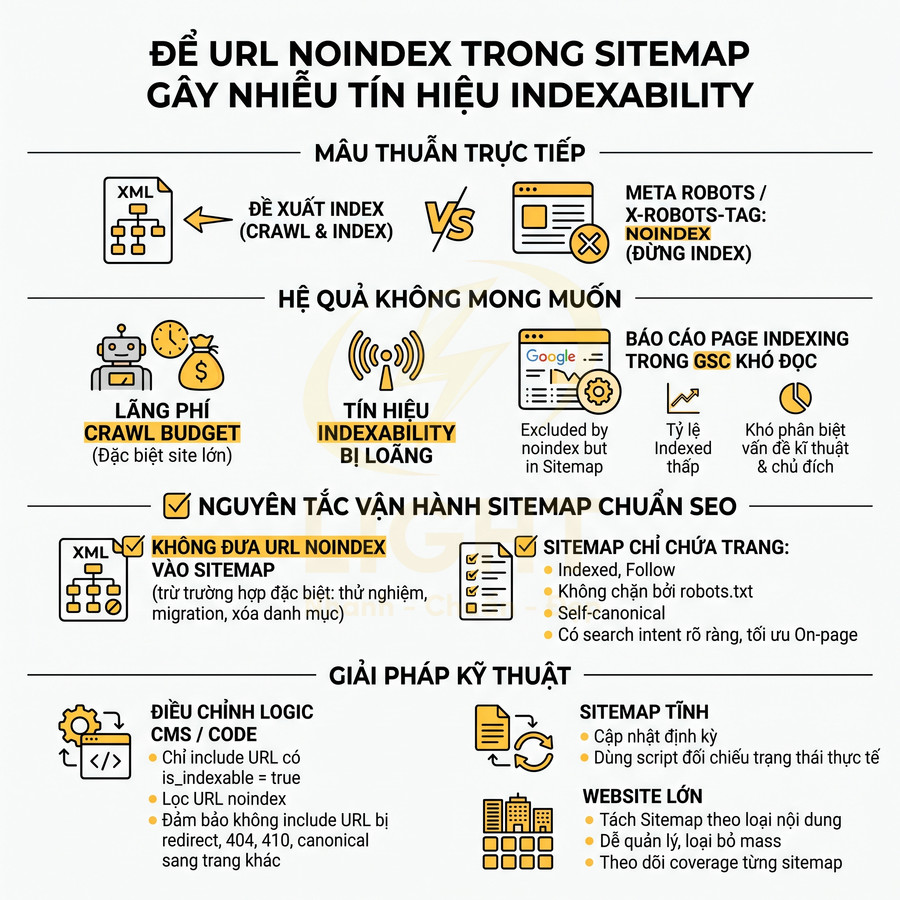
Mâu thuẫn này không khiến website bị phạt, nhưng gây ra nhiều hệ quả không mong muốn:
- Google phải liên tục crawl lại các URL noindex trong sitemap để xác nhận trạng thái, dẫn đến lãng phí crawl budget, đặc biệt với site lớn.
- Tín hiệu ưu tiên index bị “loãng” vì sitemap chứa nhiều URL mà bản chất bạn không muốn xuất hiện trên SERP.
- Báo cáo “Page indexing” trong GSC trở nên khó đọc:
- Nhiều URL bị liệt kê trong nhóm “Excluded by ‘noindex’ tag” nhưng vẫn nằm trong sitemap.
- Khó phân biệt đâu là vấn đề kỹ thuật cần xử lý, đâu là chủ đích noindex.
- Tỷ lệ “Indexed” trên tổng URL trong sitemap thấp, làm cho việc đánh giá health của sitemap và coverage trở nên thiếu chính xác.
Trên website chuẩn SEO, nguyên tắc vận hành sitemap nên được thiết kế rõ ràng:
- Không đưa URL noindex vào sitemap XML, trừ một số trường hợp đặc biệt:
- Cần theo dõi trạng thái index của một nhóm URL đang trong giai đoạn thử nghiệm.
- Cần kiểm soát quá trình deindex dần của một tập URL lớn (ví dụ: migration, xóa danh mục).
- Sitemap chỉ nên chứa:
- Trang có index, follow, không bị chặn bởi robots.txt.
- Trang có canonical tự trỏ (self-canonical), tránh đưa các URL canonical sang trang khác.
- Trang có search intent rõ ràng, được tối ưu SEO on-page (title, heading, nội dung, internal link) và có khả năng mang lại traffic.
Giải pháp kỹ thuật để làm sạch sitemap và tránh nhiễu tín hiệu:
- Điều chỉnh logic sinh sitemap trong CMS hoặc custom code:
- Chỉ include URL có trạng thái indexable trong database (ví dụ: field is_indexable = true).
- Lọc bỏ URL có meta robots noindex, x-robots-tag noindex, hoặc các flag tương đương.
- Đảm bảo không include URL bị redirect, 404, 410 hoặc canonical sang URL khác.
- Với sitemap tĩnh:
- Xây dựng quy trình cập nhật định kỳ khi thay đổi trạng thái index của URL.
- Sử dụng script nhỏ để đối chiếu danh sách URL trong sitemap với trạng thái thực tế (HTTP status, meta robots, canonical) và loại bỏ URL không còn indexable.
- Với website lớn:
- Tách sitemap theo loại nội dung (product, category, blog, v.v.) để:
- Dễ quản lý, dễ debug khi một nhóm nội dung có vấn đề index.
- Dễ loại bỏ toàn bộ block noindex (ví dụ: một nhóm category phụ) khỏi sitemap chỉ bằng cách loại bỏ một file sitemap con.
- Theo dõi coverage của từng sitemap con trong GSC để phát hiện nhanh nhóm nào có tỷ lệ index thấp bất thường.
- Tách sitemap theo loại nội dung (product, category, blog, v.v.) để:
Dùng noindex hàng loạt làm mất khả năng nhận traffic từ long-tail query
Trên các website lớn, việc “dọn rác” bằng cách noindex hàng loạt các trang được cho là “mỏng”, “ít traffic” hoặc “không quan trọng” là khá phổ biến. Tuy nhiên, nếu chỉ dựa vào dữ liệu traffic hiện tại mà không phân tích sâu search query, impression và tiềm năng long-tail, bạn có thể vô tình xóa đi một nguồn traffic bền vững và khó thay thế. Trang filter, tag, collection hoặc FAQ không nên bị đánh giá chỉ dựa trên traffic hiện tại. Trong nhiều trường hợp, các URL này phục vụ truy vấn cụ thể, có ý định rõ và giá trị chuyển đổi cao dù lượng tìm kiếm của từng từ khóa thấp. Nghiên cứu về faceted search cho thấy bộ lọc là cơ chế quan trọng giúp người dùng thu hẹp không gian thông tin đa chiều theo thuộc tính như thương hiệu, màu sắc, kích thước, giá hoặc tính năng. Vì vậy, một số tổ hợp filter có thể phản ánh nhu cầu tìm kiếm thực sự, trong khi nhiều tổ hợp khác chỉ tạo ra biến thể trùng lặp. Không nên index toàn bộ hoặc noindex toàn bộ filter. Cần phân loại dựa trên search intent, khả năng tạo landing page hữu ích, quy mô sản phẩm, mức độ khác biệt nội dung và dữ liệu impression trong Google Search Console trước khi quyết định (Niu et al., 2019).
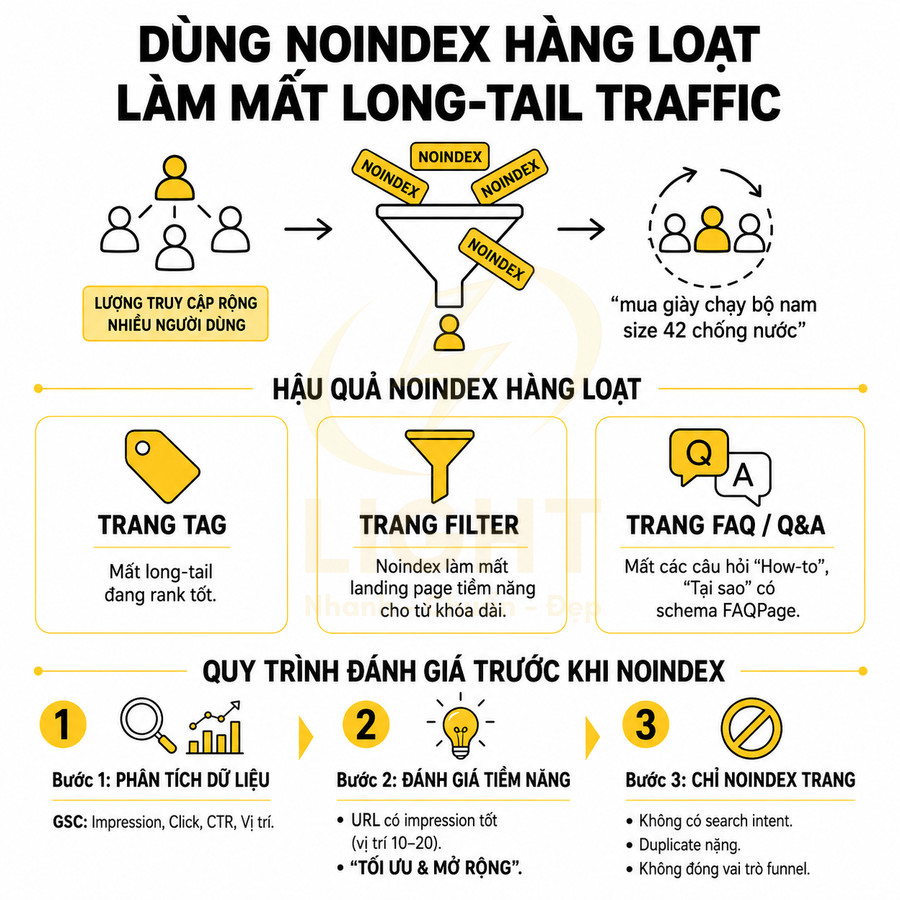
Long-tail query thường có:
- Volume thấp trên từng từ khóa, nhưng tổng hợp lại có thể chiếm tỷ trọng lớn trong tổng organic traffic.
- Search intent cụ thể, gần với hành vi mua hàng hoặc hành động chuyển đổi (ví dụ: “mua giày chạy bộ nam size 42 chống nước giá rẻ”).
- Độ cạnh tranh thấp hơn, dễ rank hơn so với head term.
Các ví dụ điển hình khi noindex hàng loạt gây mất long-tail:
- Noindex toàn bộ trang tag:
- Nhiều tag được tạo tự phát, trùng lặp, không có search intent rõ ràng – đây là nhóm nên noindex.
- Tuy nhiên, một số tag vô tình trùng với từ khóa dài mà người dùng tìm kiếm, đã có impression/click tốt.
- Noindex toàn bộ mà không phân loại sẽ làm mất những tag đang rank tốt cho long-tail.
- Noindex toàn bộ trang filter trong e-commerce:
- Nhiều combination filter thực sự có search intent (ví dụ: “áo sơ mi nam form rộng size L”, “giày chạy bộ nam size 42 chống nước”).
- Nếu được tối ưu title, H1, content bổ sung, các trang filter này có thể trở thành landing page mạnh cho long-tail.
- Noindex tất cả filter có thể làm mất hàng trăm hoặc hàng nghìn từ khóa dài tiềm năng.
- Noindex toàn bộ trang Q&A, FAQ chi tiết:
- Nhiều câu hỏi dạng “how-to”, “tại sao”, “bao lâu” có volume nhỏ nhưng rất sát nhu cầu người dùng.
- Các trang Q&A nếu được cấu trúc tốt, dùng schema FAQPage, có thể chiếm vị trí nổi bật trên SERP.
- Gắn nhãn “thin content” một cách máy móc và noindex toàn bộ sẽ làm mất đi nguồn traffic này.
Để tránh mất long-tail traffic, cần quy trình đánh giá trước khi noindex hàng loạt:
- Phân tích dữ liệu search query:
- Dùng GSC để:
- Lọc theo folder hoặc pattern URL (tag, filter, FAQ).
- Xem impression, click, CTR, average position của từng URL.
- Không chỉ dựa vào session trong analytics, vì nhiều URL có impression tốt nhưng CTR thấp vẫn là cơ hội tối ưu.
- Dùng GSC để:
- Đánh giá tiềm năng thay vì chỉ nhìn hiện trạng:
- URL có một ít impression, vị trí trung bình 10–20, nội dung còn sơ sài thường là ứng viên tốt để tối ưu và mở rộng nội dung thay vì noindex. Một URL có traffic thấp chưa chắc là URL không có giá trị. Vị trí trung bình ở nhóm 10–20, có impression ổn định hoặc nhận được click lẻ tẻ có thể cho thấy công cụ tìm kiếm đã nhận diện được mức độ liên quan ban đầu nhưng chưa đủ cơ sở để xếp hạng cao hơn. Với các URL như vậy, hướng xử lý nên là kiểm tra search intent, tăng chiều sâu nội dung, làm rõ thực thể chính, bổ sung internal link và loại bỏ trùng lặp trước khi cân nhắc noindex. Nghiên cứu về crawling hướng chủ đề cho thấy chất lượng và mức độ liên quan của trang đích có ảnh hưởng trực tiếp đến việc lựa chọn đường dẫn crawl trong hệ thống thu thập dữ liệu. Noindex chỉ phù hợp khi URL không có giá trị riêng và không đáng để cải thiện, không phải chỉ vì hiện tại chưa tạo nhiều phiên truy cập (Pal, Tomar, & Shrivastava, 2009).
- Có thể gom nhóm nhiều trang rất gần nhau thành một landing page mạnh hơn, rồi redirect 301 thay vì noindex rời rạc.
- Chỉ noindex những trang:
- Không có search intent riêng, không thể (hoặc không đáng) tối ưu thành landing page.
- Gây duplicate/near-duplicate nghiêm trọng, làm loãng index (ví dụ: filter chỉ thay đổi thứ tự, màu sắc không có nhu cầu tìm kiếm riêng).
- Không đóng vai trò trong funnel chuyển đổi hoặc điều hướng người dùng.
Noindex lâu dài có thể khiến Google giảm theo dõi link trên trang đó
Về mặt lý thuyết, thẻ noindex, follow cho phép Google không index trang nhưng vẫn crawl và theo các link trên trang đó. Tuy nhiên, trong thực tế vận hành, nếu một URL bị noindex trong thời gian dài, không nhận được tín hiệu giá trị (không traffic, không backlink, không được nhắc đến trong sitemap), Google có xu hướng:
- Giảm tần suất crawl trang đó để tối ưu tài nguyên.
- Giảm mức độ ưu tiên khi sử dụng các link trên trang đó để khám phá URL mới.
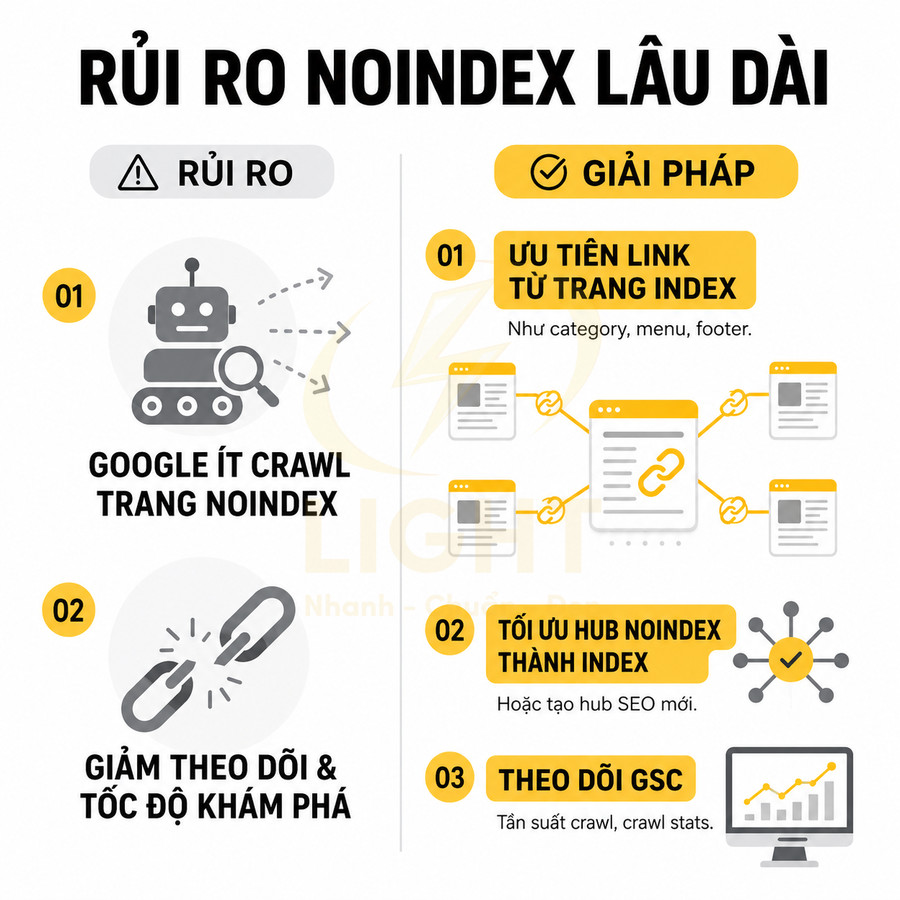
Điều này dẫn đến rủi ro gián tiếp cho hệ thống internal link:
- Các trang archive, tag, filter noindex nhưng chứa nhiều internal link đến sản phẩm hoặc bài viết mới:
- Nếu Google ít crawl các trang hub này, tốc độ khám phá URL mới sẽ chậm lại.
- Các link từ những hub noindex có thể mang ít trọng số hơn so với link từ các trang index.
- Các trang hub nội bộ dùng để điều hướng người dùng nhưng bị noindex:
- Ví dụ: trang “trung tâm tài nguyên”, “danh sách chủ đề”, “bản đồ site HTML” chỉ để noindex.
- Nếu đây là điểm tập trung nhiều internal link, việc Google giảm crawl sẽ làm suy yếu khả năng phân phối PageRank nội bộ.
Giải pháp để hạn chế rủi ro này:
- Không phụ thuộc hoàn toàn vào các trang noindex để phân phối internal link:
- Các URL quan trọng (money page, pillar content, category chính) nên được link từ trang index như:
- Category, subcategory.
- Bài viết liên quan, module “bài nổi bật”.
- Menu, footer, breadcrumb, hub indexable.
- Các URL quan trọng (money page, pillar content, category chính) nên được link từ trang index như:
- Nếu một trang noindex đóng vai trò hub quan trọng, cân nhắc:
- Chuyển sang index nếu có thể tối ưu để phù hợp search intent:
- Bổ sung nội dung giới thiệu, mô tả nhóm nội dung.
- Tối ưu title, H1, internal link, schema nếu cần.
- Hoặc tạo một phiên bản index khác làm hub SEO:
- Trang indexable được tối ưu cho search, đóng vai trò landing page.
- Trang noindex chỉ phục vụ điều hướng nội bộ, test, hoặc use case đặc biệt.
- Chuyển sang index nếu có thể tối ưu để phù hợp search intent:
- Theo dõi crawl stats trong GSC:
- Kiểm tra xem Google có còn crawl đều các URL quan trọng được link từ trang noindex hay không.
- Nếu thấy tần suất crawl giảm mạnh, cần:
- Tăng số lượng và chất lượng internal link từ các trang index.
- Xem xét lại chiến lược noindex cho các hub quan trọng.
Các URL chiến lược cần có nhiều đường dẫn khám phá từ cấu trúc indexable: danh mục chính, bài viết liên quan, breadcrumb, hub nội dung, sitemap XML và các liên kết biên tập trong phần thân bài. Cách tổ chức này giúp giảm rủi ro khi một template filter, trang tìm kiếm nội bộ hoặc archive bị giảm tần suất crawl, thay đổi rule hoặc bị loại bỏ khỏi website. Nghiên cứu về crawler tăng dần chỉ ra rằng việc tái thu thập trang phụ thuộc vào các quyết định ưu tiên; do đó, không phải mọi URL đều được làm mới với tần suất như nhau. Một kiến trúc SEO bền vững cần bảo đảm trang quan trọng vẫn được phát hiện và tiếp cận qua nhiều node có giá trị, thay vì chỉ được “giấu” trong một khu vực noindex. Điều này cũng giúp người dùng tìm nội dung nhanh hơn, không chỉ tối ưu cho bot (Cho & Garcia-Molina, 2003).
Quy trình audit trang nên noindex trên website lớn
Quy trình audit noindex trên website lớn cần dựa trên một framework dữ liệu rõ ràng, kết hợp phân loại URL đa chiều và kiểm chứng bằng công cụ. Trước hết, nhóm URL theo loại trang, search intent, hiệu suất (traffic, chuyển đổi, backlink) và vai trò trong cấu trúc internal link để nhận diện những trang không mang lại giá trị hoặc gây loãng index. Tiếp theo, dùng Google Search Console để đối chiếu trạng thái index, phát hiện URL bị noindex nhầm, trùng lặp hoặc “crawled not indexed” cần nâng cấp hoặc loại bỏ. Song song, crawl toàn site để tìm mâu thuẫn giữa meta robots, canonical, status code và sitemap. Cuối cùng, phân tích log server nhằm phát hiện khu vực lãng phí crawl budget, từ đó tinh chỉnh rule noindex, robots.txt và internal link một cách nhất quán, bền vững. Audit noindex hiệu quả cần kiểm tra URL như một tập tín hiệu liên kết với nhau, không xem riêng lẻ từng thẻ meta. Một URL có thể đồng thời trả về mã 200, chứa noindex, canonical sang URL khác, nằm trong sitemap và bị liên kết mạnh từ menu — đây là cấu hình cần được phân tích theo mục tiêu kinh doanh thay vì kết luận vội là lỗi hay đúng. Crawler nội bộ nên thu thập tối thiểu status code, canonical, meta robots, X-Robots-Tag, khả năng index, inlink, outlink và trạng thái xuất hiện trong sitemap. Sau đó, cần đối chiếu với dữ liệu traffic, chuyển đổi và backlink để tìm các URL bị noindex nhầm. Không có một directive kỹ thuật nào đủ để đánh giá giá trị URL nếu thiếu dữ liệu về vai trò thực tế của trang trong hệ thống. Các nghiên cứu về crawler hiện đại cũng nhấn mạnh sự đa dạng của trạng thái, cấu trúc và loại tài nguyên trên web, khiến audit theo một cột dữ liệu duy nhất dễ bỏ sót vấn đề (Chang et al., 2022).
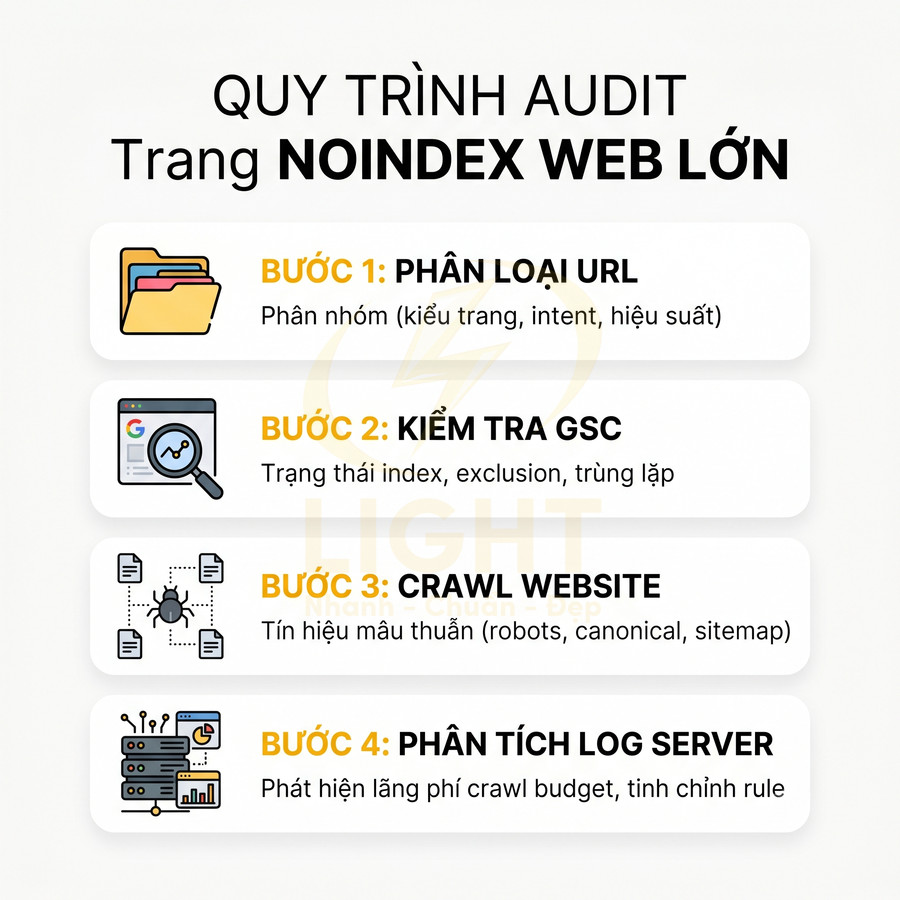
Phân loại URL theo intent, traffic, chuyển đổi, backlink và vai trò internal link
Trên website lớn, quyết định trang nào nên noindex cần dựa trên một framework rõ ràng, có dữ liệu hỗ trợ, thay vì cảm tính. Mục tiêu là xác định chính xác những URL:
- Không mang lại giá trị SEO hoặc kinh doanh.
- Gây loãng crawl budget và index budget.
- Tạo trùng lặp, cannibalization hoặc nhiễu tín hiệu cho các trang quan trọng.
Cốt lõi của quy trình là phân loại URL đa chiều, sau đó áp dụng ma trận quyết định nhất quán trên toàn site.
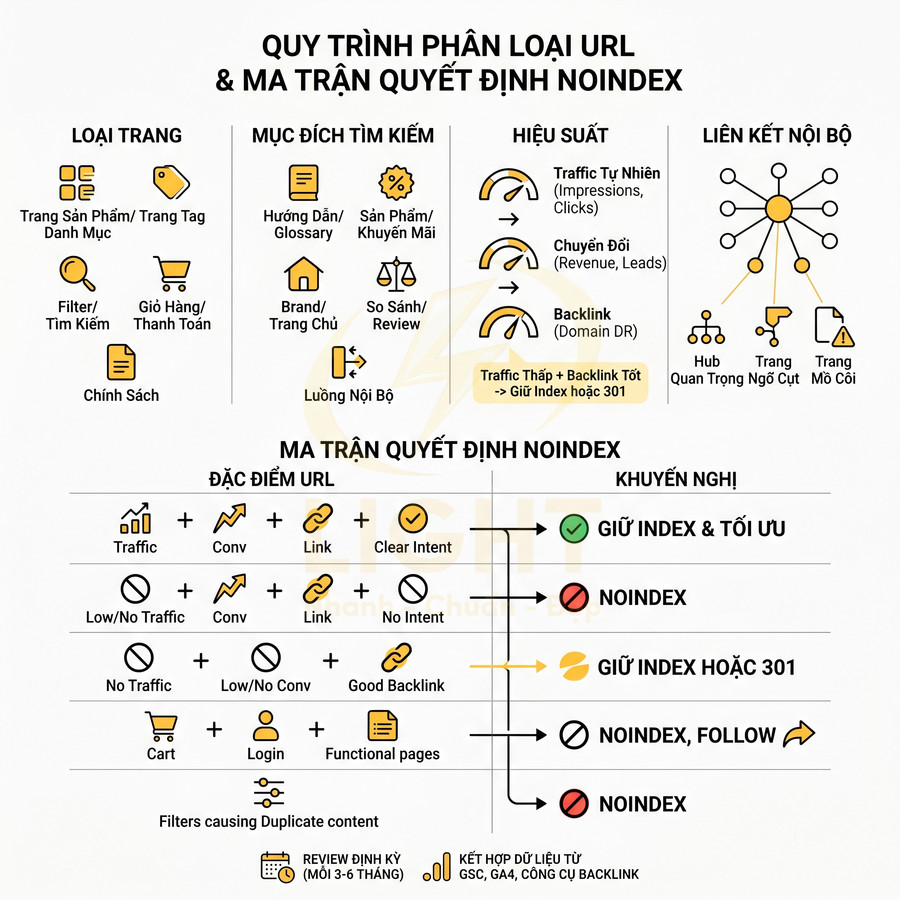
1. Phân loại theo loại trang (page type)
- Trang kinh doanh chính:
- Trang sản phẩm (PDP), danh mục (PLP), bài viết blog, landing page SEO/paid.
- Thường là nhóm ưu tiên giữ index, tối ưu nội dung và internal link.
- Trang điều hướng và khám phá:
- Trang tag, topic hub, collection, series, archive theo tháng/năm.
- Cần đánh giá kỹ nguy cơ duplicate với category hoặc bài viết chính.
- Trang sinh bởi hệ thống:
- Filter, sort, search result nội bộ, pagination sâu, trang tham số (utm, ref, session).
- Nhóm này thường là ứng viên mạnh cho noindex hoặc canonical.
- Trang chức năng:
- Login, register, cart, checkout, profile, dashboard, reset password.
- Không có search intent riêng, chỉ phục vụ luồng thao tác user.
- Trang thông tin tĩnh:
- Chính sách, giới thiệu, liên hệ, FAQ, điều khoản sử dụng.
- Một số trang có thể có search intent (ví dụ: chính sách hoàn tiền), cần đánh giá riêng.
2. Phân loại theo search intent
- Informational:
- Bài viết hướng dẫn, kiến thức, how-to, glossary.
- Cần đánh giá trùng lặp chủ đề, cannibalization giữa nhiều bài cùng intent.
- Transactional:
- Trang sản phẩm, giỏ hàng, combo, bundle, khuyến mãi.
- Ưu tiên giữ index nếu có volume tìm kiếm và phù hợp funnel mua hàng.
- Navigational:
- Trang brand, category chính, trang chủ, hub điều hướng.
- Thường là core của cấu trúc site, cần index và tối ưu internal link.
- Commercial investigation:
- So sánh, review, top list, best X for Y.
- Nhóm này thường có giá trị cao về traffic và chuyển đổi assisted.
- Trang không có search intent riêng:
- Trang chỉ tồn tại để phục vụ flow nội bộ (checkout step 2, confirm email, v.v.).
- Là ứng viên mặc định cho noindex, follow.
3. Phân loại theo hiệu suất (performance & value)
Cần gom dữ liệu từ GA4, GSC và công cụ backlink để đánh giá từng URL hoặc nhóm URL:
- Traffic organic:
- Sessions, users, impressions, clicks, CTR.
- Phân tách theo brand vs non-brand, device, quốc gia nếu cần.
- Chuyển đổi:
- Doanh thu trực tiếp, lead, sign-up, add-to-cart, assisted conversion.
- Đánh giá cả last-click và multi-touch (nếu có mô hình attribution).
- Backlink:
- Số lượng referring domains, chất lượng domain (DR/TF), anchor text.
- Phân biệt backlink editorial vs spam, paid, sitewide.
URL có traffic thấp nhưng giữ nhiều backlink chất lượng vẫn là tài sản SEO, thường nên giữ index hoặc 301 sang trang liên quan thay vì noindex.
4. Phân loại theo vai trò internal link & kiến trúc thông tin
- Hub quan trọng:
- Trang nhận nhiều internal link in và chứa nhiều link out đến cluster nội dung.
- Thường là category, tag chính, topic hub; rất quan trọng cho crawl & PageRank nội bộ.
- Trang ngõ cụt:
- Trang chỉ nhận traffic từ external hoặc từ 1–2 internal link, không dẫn user đi đâu.
- Cần xem xét bổ sung internal link hoặc gộp/nâng cấp nội dung.
- Trang ít được link nội bộ:
- Thường là orphan hoặc near-orphan URL.
- Nếu không có traffic, không có backlink, không có intent rõ, là ứng viên mạnh cho noindex hoặc xóa.
5. Xây dựng ma trận quyết định noindex
Sau khi phân loại, áp dụng ma trận quyết định để đảm bảo tính nhất quán trên toàn site. Ma trận mẫu:
| Đặc điểm URL | Khuyến nghị |
|---|---|
| Có traffic, có chuyển đổi, có backlink, search intent rõ | Giữ index, tối ưu thêm |
| Không traffic, không chuyển đổi, không backlink, không search intent riêng | Noindex hoặc 404/410 nếu không cần cho user |
| Không traffic nhưng có backlink chất lượng | Giữ index hoặc 301 sang trang liên quan, tránh noindex |
| Trang hệ thống, chỉ phục vụ thao tác (login, cart, checkout) | Noindex, follow |
| Trang filter, sort gây duplicate | Noindex hoặc canonical về trang chính |
Khi triển khai trên website lớn, nên:
- Chuẩn hóa rule theo pattern URL (thư mục, tham số, loại template).
- Document rõ: loại trang nào luôn index, loại nào luôn noindex, loại nào cần review case-by-case.
- Định kỳ (ví dụ mỗi 3–6 tháng) re-audit để cập nhật theo thay đổi sản phẩm, content và hành vi tìm kiếm.
Quy trình này cần dữ liệu từ nhiều nguồn: Google Analytics/GA4, Google Search Console, công cụ backlink (Ahrefs, Majestic, v.v.) và crawler nội bộ. Việc kết hợp dữ liệu giúp quyết định noindex dựa trên bằng chứng, phù hợp với tiêu chuẩn EEAT và chiến lược SEO dài hạn.
Kiểm tra Google Search Console cho indexed, excluded, crawled not indexed và duplicate
Báo cáo Page indexing trong GSC là lớp kiểm chứng quan trọng cho chiến lược noindex. Không chỉ xem URL nào đang index, mà còn phải hiểu lý do Google loại trừ hoặc bỏ qua một số URL.
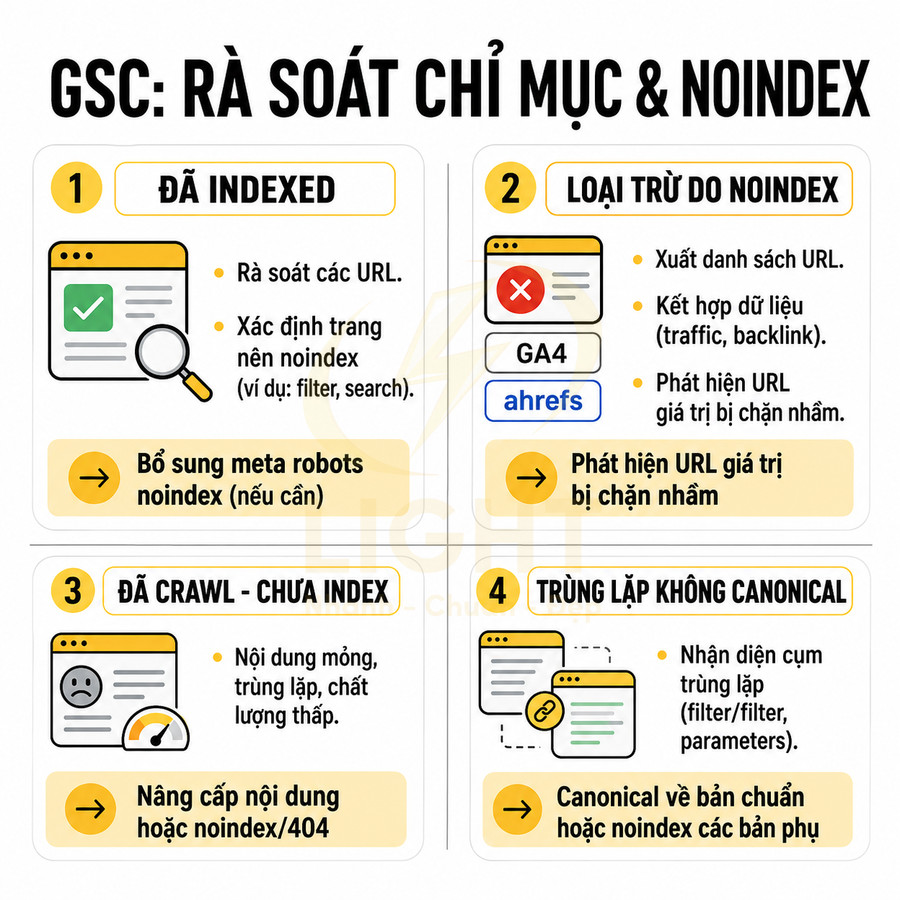
1. Nhóm Indexed
- Rà soát các pattern URL:
- Xác định xem có loại trang nào lẽ ra phải noindex nhưng vẫn đang index (ví dụ: filter, sort, kết quả search nội bộ).
- Kiểm tra các URL thin content, auto-generated, tag/archive ít giá trị nhưng vẫn index.
- Đối chiếu với ma trận:
- Nếu URL thuộc nhóm “chỉ phục vụ thao tác” nhưng vẫn index, cần bổ sung meta robots noindex.
2. Nhóm Excluded by ‘noindex’ tag
- Export toàn bộ danh sách URL trong nhóm này.
- Join với:
- Traffic & conversion (GA4).
- Backlink (Ahrefs/Majestic).
- Mục tiêu:
- Phát hiện URL có giá trị (traffic, chuyển đổi, backlink) nhưng đang bị noindex nhầm.
- Phát hiện rule noindex đang áp dụng quá rộng (ví dụ: chặn cả một thư mục chứa cả trang quan trọng).
3. Nhóm Crawled – currently not indexed
- Đây là nhóm URL Google đã crawl nhưng quyết định chưa index:
- Thường do nội dung mỏng, trùng lặp, chất lượng thấp hoặc không có nhu cầu tìm kiếm.
- Quy trình xử lý:
- Sample theo từng pattern URL (không nhất thiết phải review từng URL nếu số lượng rất lớn).
- Đánh giá:
- Nội dung có thể nâng cấp để trở thành trang index-worthy không.
- Nếu không, cân nhắc noindex hoặc 404/410 để dọn chỉ mục.
4. Nhóm Duplicate without user-selected canonical
- Nhận diện các cluster trùng lặp:
- URL có nội dung gần giống nhau (ví dụ: filter, sort, pagination, phiên bản có/không tham số).
- Quyết định chiến lược:
- Dùng canonical về phiên bản chuẩn nếu vẫn muốn cho phép crawl nhưng gom tín hiệu.
- Dùng noindex cho các bản phụ nếu không muốn chúng xuất hiện trong SERP.
- Tránh:
- Kết hợp canonical + noindex trên cùng URL một cách không có chủ đích, vì có thể gây nhiễu tín hiệu.
Việc sử dụng GSC như một phần của quy trình audit giúp đảm bảo rằng quyết định noindex không chỉ dựa trên cấu trúc URL mà còn dựa trên cách Google thực sự nhìn nhận và xử lý website.
Crawl website để phát hiện meta robots, canonical, status code và sitemap mâu thuẫn
Crawler (Screaming Frog, Sitebulb, DeepCrawl, v.v.) cho phép nhìn website từ góc nhìn của bot. Trong ngữ cảnh noindex, mục tiêu là phát hiện các tín hiệu mâu thuẫn khiến Google khó hiểu đâu là URL nên index.
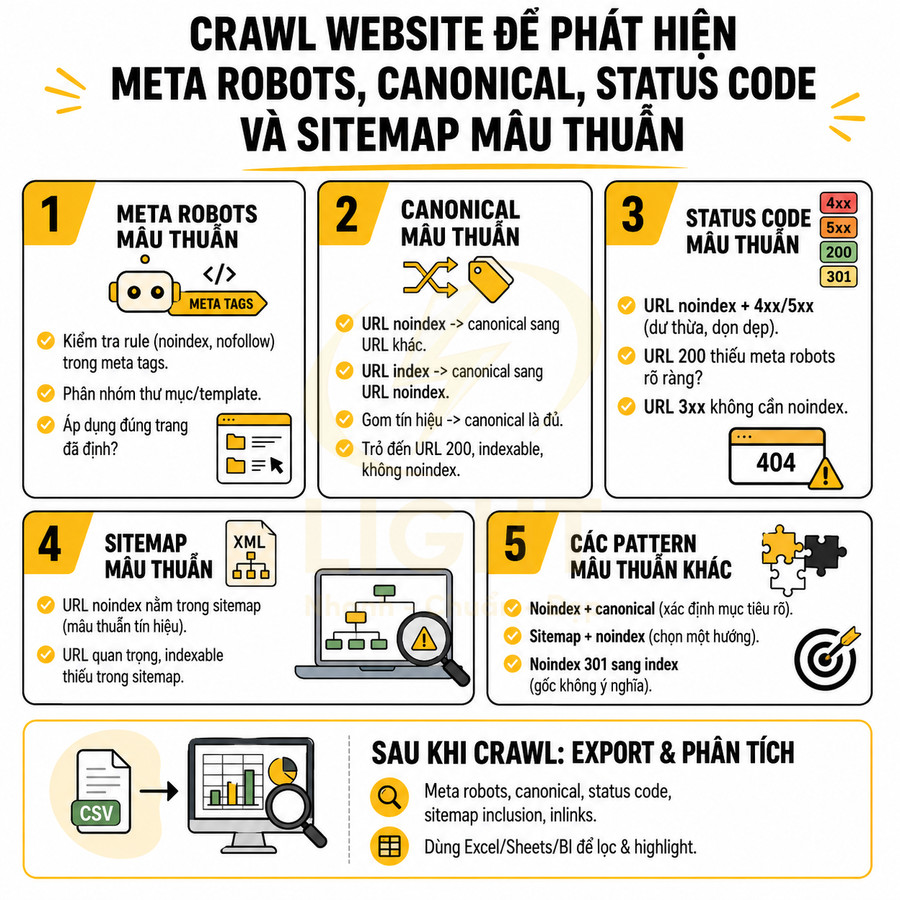
1. Meta robots
- Liệt kê toàn bộ URL có:
noindex,nofollow,noarchive, kết hợp nhưnoindex,follow.
- Phân nhóm theo:
- Thư mục (ví dụ: /search/, /filter/, /user/).
- Template (product, category, blog, system page).
- Đánh giá:
- Rule noindex có đang áp dụng đúng loại trang đã định trong ma trận không.
2. Canonical
- Phát hiện các pattern:
- URL noindex nhưng canonical trỏ đến URL khác.
- URL index nhưng canonical trỏ đến URL noindex.
- Nguyên tắc:
- Nếu đã canonical về một URL khác để gom tín hiệu, thường không cần thêm noindex trên bản phụ, trừ khi có lý do rất cụ thể.
- Canonical nên trỏ đến URL trả về 200, indexable, không noindex.
3. Status code
- Kiểm tra:
- URL noindex nhưng trả về 4xx hoặc 5xx:
- Noindex trở nên dư thừa, nên dọn dẹp để giảm phức tạp cấu hình.
- URL 200 nhưng:
- Không có meta robots rõ ràng trong khi thuộc nhóm cần kiểm soát index.
- URL noindex nhưng trả về 4xx hoặc 5xx:
- Đảm bảo:
- URL 3xx (301/302) không cần gắn noindex, vì bot sẽ theo redirect.
4. Sitemap
- Đối chiếu giữa sitemap và trạng thái indexability:
- URL noindex vẫn nằm trong sitemap:
- Tín hiệu mâu thuẫn: sitemap nói “hãy index”, meta robots nói “đừng index”.
- URL quan trọng, indexable nhưng không có trong sitemap:
- Có thể khiến Google phát hiện chậm hoặc crawl ít hơn cần thiết.
- URL noindex vẫn nằm trong sitemap:
5. Một số pattern mâu thuẫn thường gặp
- noindex + canonical đến URL khác:
- Nên xác định rõ mục tiêu:
- Nếu muốn loại bản phụ khỏi SERP nhưng vẫn chuyển tín hiệu, có thể chấp nhận.
- Nếu chỉ cần gom tín hiệu, canonical là đủ, không cần noindex.
- Nên xác định rõ mục tiêu:
- URL trong sitemap nhưng noindex:
- Cần chọn một hướng:
- Hoặc bỏ khỏi sitemap nếu thực sự không muốn index.
- Hoặc bỏ noindex nếu muốn index và URL đủ chất lượng.
- Cần chọn một hướng:
- URL noindex nhưng 301 sang URL index:
- Noindex trên URL gốc không còn ý nghĩa sau khi redirect.
- Nên dọn rule cũ để tránh nhầm lẫn khi audit sau này.
Sau khi crawl, nên export dữ liệu (meta robots, canonical, status code, sitemap inclusion, inlinks) và dùng Excel/Sheets hoặc BI tool để lọc, pivot, highlight các trường hợp mâu thuẫn cần xử lý.
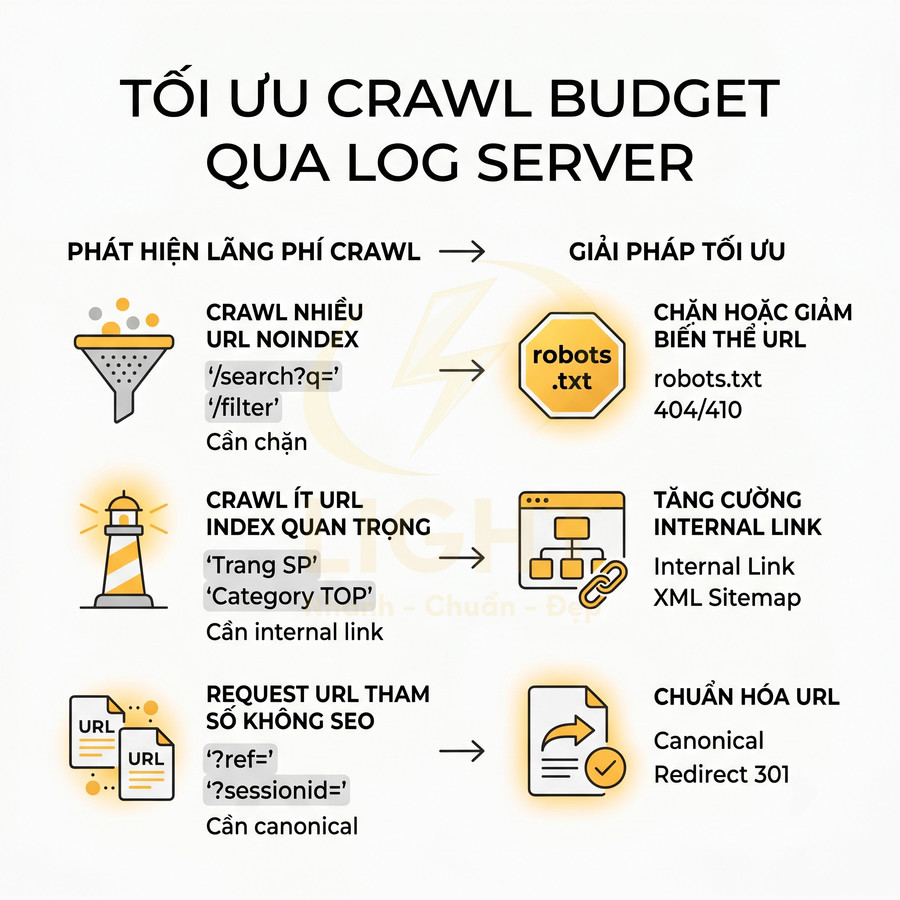
Đối chiếu log server để xác định khu vực gây lãng phí crawl budget
Với website lớn, crawl budget là tài nguyên hữu hạn. Log server cho phép thấy chính xác Googlebot đang tiêu tốn crawl budget vào đâu, từ đó điều chỉnh chiến lược noindex, robots.txt và internal link.
1. Chuẩn bị & xử lý log
- Trích xuất log trong ít nhất 30 ngày (tốt hơn 60–90 ngày cho site rất lớn).
- Lọc theo user-agent:
- Googlebot (desktop, smartphone), có thể thêm Bingbot, các bot quan trọng khác.
- Chuẩn hóa URL:
- Loại bỏ tham số tracking (utm, fbclid, gclid) nếu không có giá trị SEO.
- Gom nhóm theo pattern: thư mục, loại trang, tham số filter/sort.
- Join với dữ liệu từ crawler:
- Meta robots, status code, canonical, sitemap inclusion.
2. Phát hiện khu vực lãng phí crawl budget
- Googlebot crawl rất nhiều URL noindex:
- Ví dụ: /search?q=, /filter?color=, /sort=price_asc.
- Câu hỏi cần trả lời:
- Những URL này có cần tồn tại cho user không?
- Nếu không, có thể 404/410 hoặc chặn bằng robots.txt.
- Nếu cần cho user nhưng không cần SEO, noindex là đúng, nhưng có thể giảm số lượng biến thể bằng cách giới hạn tham số.
- Googlebot ít crawl các URL index quan trọng:
- Trang sản phẩm chủ lực, category top, landing page chuyển đổi cao.
- Hướng xử lý:
- Tăng internal link từ hub, homepage, sitemap HTML.
- Đảm bảo các URL này nằm trong XML sitemap và không bị chặn bởi robots.txt hoặc noindex.
- Giảm số lượng URL phụ (filter, sort, archive sâu) để dồn crawl budget.
- Nhiều request đến URL tham số không có giá trị SEO:
- Ví dụ: /product?ref=, /category?page=99, /?sessionid=.
- Giải pháp:
- Chuẩn hóa URL (canonical, redirect 301 về bản chuẩn).
- Cân nhắc noindex cho các pattern không thể loại bỏ nhưng không cần xuất hiện trên SERP.
3. Tinh chỉnh chiến lược noindex dựa trên log
- Nếu một khu vực noindex vẫn bị crawl quá nhiều:
- Xem xét:
- Chặn bằng robots.txt nếu không cần Google đọc nội dung.
- Giảm internal link trỏ đến khu vực đó.
- Giảm số lượng biến thể URL được tạo ra (giới hạn filter, sort, pagination).
- Xem xét:
- Nếu khu vực index quan trọng crawl quá ít:
- Tăng tín hiệu:
- Internal link từ các trang có crawl frequency cao.
- Đảm bảo không có mâu thuẫn meta robots/canonical/sitemap.
- Tăng tín hiệu:
Phân tích log server là bước nâng cao nhưng mang lại insight trực tiếp về hành vi của Googlebot, giúp điều chỉnh noindex và cấu trúc site để tối ưu hóa cả crawl budget lẫn hiệu suất SEO tổng thể.
Checklist trước khi thêm noindex vào website chuẩn SEO
Trước khi áp dụng noindex, cần đánh giá toàn diện vai trò của URL trong chiến lược SEO và trải nghiệm người dùng. Tập trung phân tích xem trang có search intent riêng, có thể trở thành landing page SEO, mang lại traffic organic, chuyển đổi hoặc nhận backlink chất lượng hay không. Đồng thời, xem URL có nằm trong sitemap XML, được internal link từ menu, footer, breadcrumb, hub nội dung hoặc dùng làm landing page chiến dịch dài hạn. Về kỹ thuật, bảo đảm các tín hiệu meta robots, canonical, robots.txt và status code không xung đột, ưu tiên cấu hình noindex, follow cho các trang chức năng vẫn cần tồn tại. Nếu URL không có giá trị SEO hiện tại và tương lai, noindex giúp tập trung crawl budget cho các trang chiến lược.
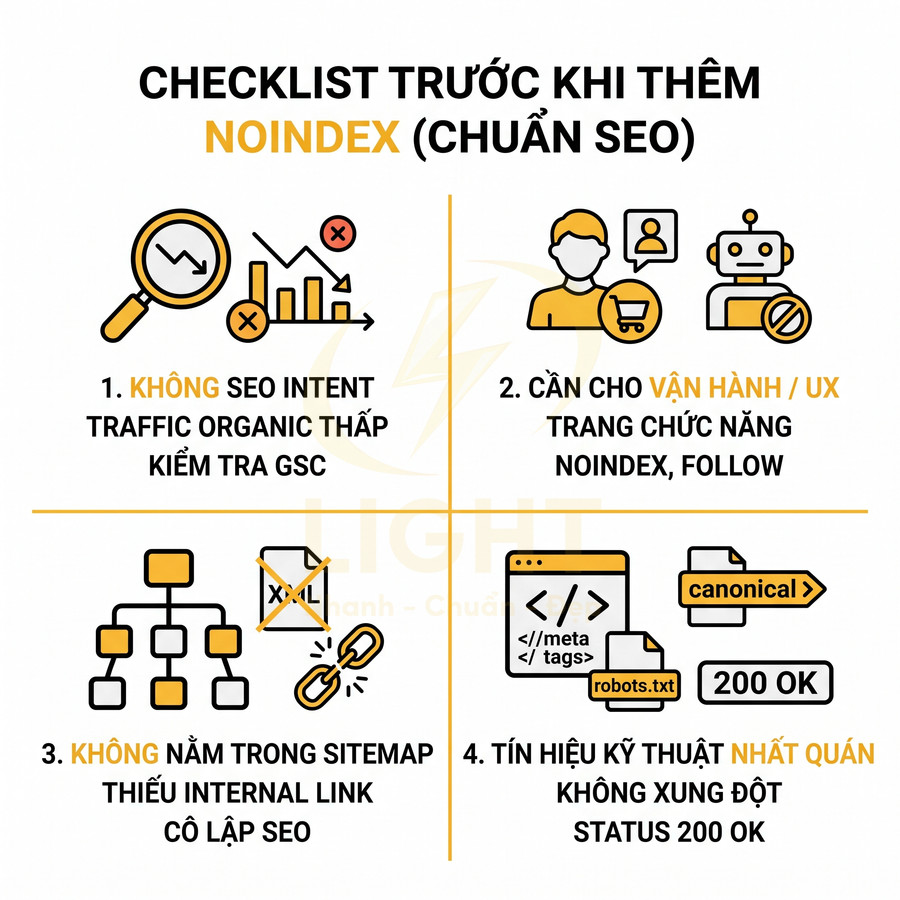
URL không có search intent riêng, traffic organic hoặc vai trò landing page
Trước khi quyết định noindex một URL, cần phân tích ở mức độ chi tiết hơn thay vì chỉ dựa vào cảm tính. Câu hỏi trung tâm vẫn là: URL này có search intent riêng và có thể/đang đóng vai trò landing page SEO hay không? Tuy nhiên, để trả lời chính xác, nên đánh giá theo nhiều lớp dữ liệu: hành vi người dùng, dữ liệu từ công cụ tìm kiếm, vai trò trong funnel chuyển đổi và tiềm năng tối ưu trong tương lai.
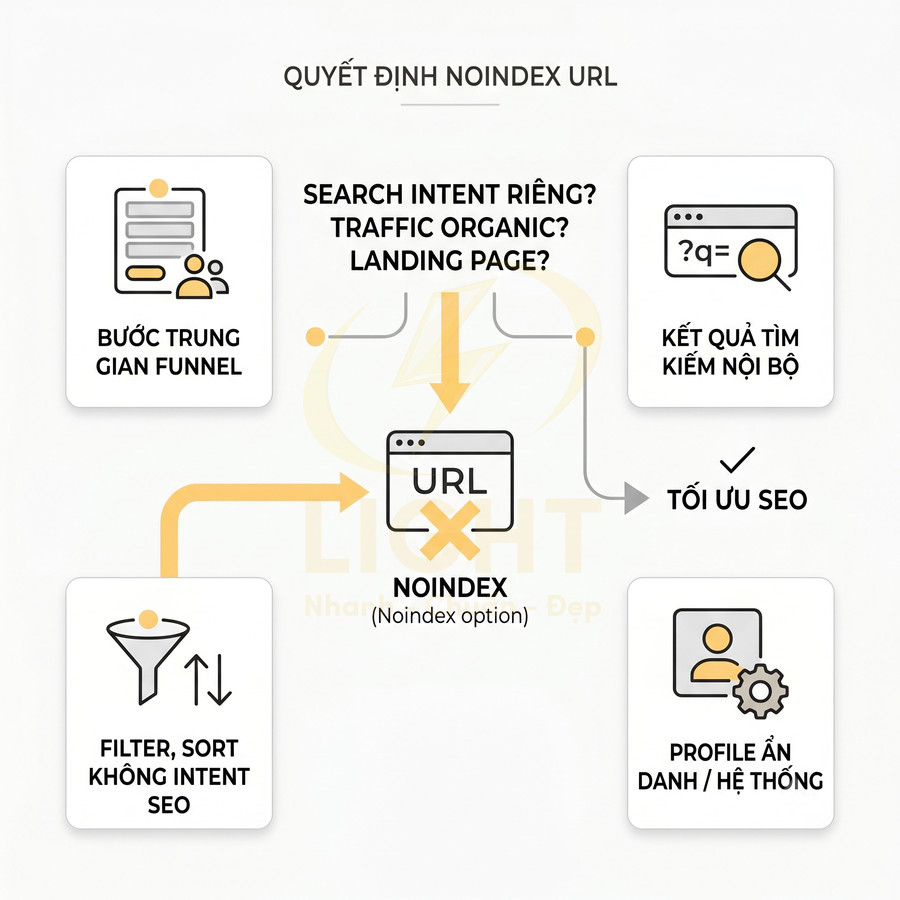
Các loại URL thường thỏa điều kiện noindex, khi phân tích sâu hơn:
- Trang bước trung gian trong funnel:
- Ví dụ: bước 2/3 của form đăng ký nhiều bước, bước xác nhận thông tin trước thanh toán, bước chọn phương thức giao hàng.
- Đặc điểm:
- Không cung cấp ngữ cảnh đầy đủ nếu người dùng vào trực tiếp (thiếu dữ liệu từ bước trước).
- Thường gây lỗi hoặc trải nghiệm kém nếu truy cập trực tiếp (session hết hạn, không có giỏ hàng, không có dữ liệu form).
- Không có từ khóa mục tiêu riêng; nội dung gần như trùng lặp với các bước khác, chỉ khác về trạng thái.
- Trang kết quả tìm kiếm nội bộ:
- URL thường chứa query động (ví dụ: ?q=abc, &search=xyz).
- Không ổn định về nội dung, phụ thuộc hoàn toàn vào input người dùng.
- Khó kiểm soát chất lượng nội dung hiển thị, dễ tạo ra thin content hoặc trang trống.
- Trang filter, sort không tạo ra search intent riêng:
- Các filter chỉ thay đổi thứ tự hoặc một vài thuộc tính hiển thị (sort theo giá, sort theo mới nhất, đổi layout grid/list).
- Các URL dạng này thường sinh ra hàng loạt biến thể, gây lãng phí crawl budget nếu được index.
- Chỉ nên cân nhắc index khi filter đó tương ứng với một search intent rõ ràng (ví dụ: “áo thun nam màu đen size L” là một tập sản phẩm có nhu cầu tìm kiếm thực sự).
- Trang profile ẩn danh hoặc trang hệ thống:
- Profile không có nội dung hữu ích cho người dùng bên ngoài (chỉ hiển thị ID, username, không có thông tin mô tả, không có giá trị tham khảo).
- Các trang hệ thống như trang thông báo lỗi nội bộ, trang redirect trung gian, trang xác nhận kỹ thuật.
Checklist nhanh, mở rộng theo góc nhìn chuyên môn:
- URL có impression/click đáng kể trong GSC không?
- Kiểm tra thêm:
- CTR có ổn định và cao hơn mức trung bình site không?
- Vị trí trung bình có xu hướng cải thiện theo thời gian không?
- Kiểm tra thêm:
- URL có chuyển đổi hoặc đóng góp vào funnel không?
- Gắn event/goal trong analytics để xem:
- URL có nằm trong các path chuyển đổi phổ biến không?
- Thời gian trên trang, tỷ lệ thoát, số trang/phiên có cho thấy người dùng thực sự tương tác không?
- Gắn event/goal trong analytics để xem:
- URL có backlink chất lượng trỏ đến không?
- Nếu có backlink từ domain uy tín, cần cân nhắc:
- Có nên giữ index và tối ưu lại nội dung để tận dụng link equity?
- Hoặc redirect 301 sang một URL mạnh hơn, thay vì noindex?
- Nếu có backlink từ domain uy tín, cần cân nhắc:
- URL có thể được tối ưu thành landing page hữu ích cho một nhóm từ khóa cụ thể không?
- Nếu có tiềm năng:
- Xác định cụm từ khóa (topic cluster) phù hợp.
- Bổ sung nội dung, cấu trúc heading, internal link để biến nó thành trang SEO thực thụ.
- Nếu có tiềm năng:
Nếu tất cả câu trả lời đều là “không”, và không có kế hoạch phát triển SEO cho URL đó trong tương lai gần, noindex là lựa chọn hợp lý để giữ website gọn, tập trung và chuẩn SEO, đồng thời tối ưu hóa phân bổ crawl budget cho các URL chiến lược.
Trang vẫn cần tồn tại cho người dùng, quy trình vận hành hoặc tính năng website
Một nhóm lớn URL không nên xuất hiện trên SERP nhưng vẫn bắt buộc phải tồn tại để đảm bảo trải nghiệm người dùng, luồng nghiệp vụ và tính toàn vẹn của hệ thống. Trong các trường hợp này, noindex là lớp “lọc SEO” hợp lý, trong khi vẫn giữ nguyên khả năng truy cập thông qua điều hướng nội bộ, session, hoặc các bước trong funnel.
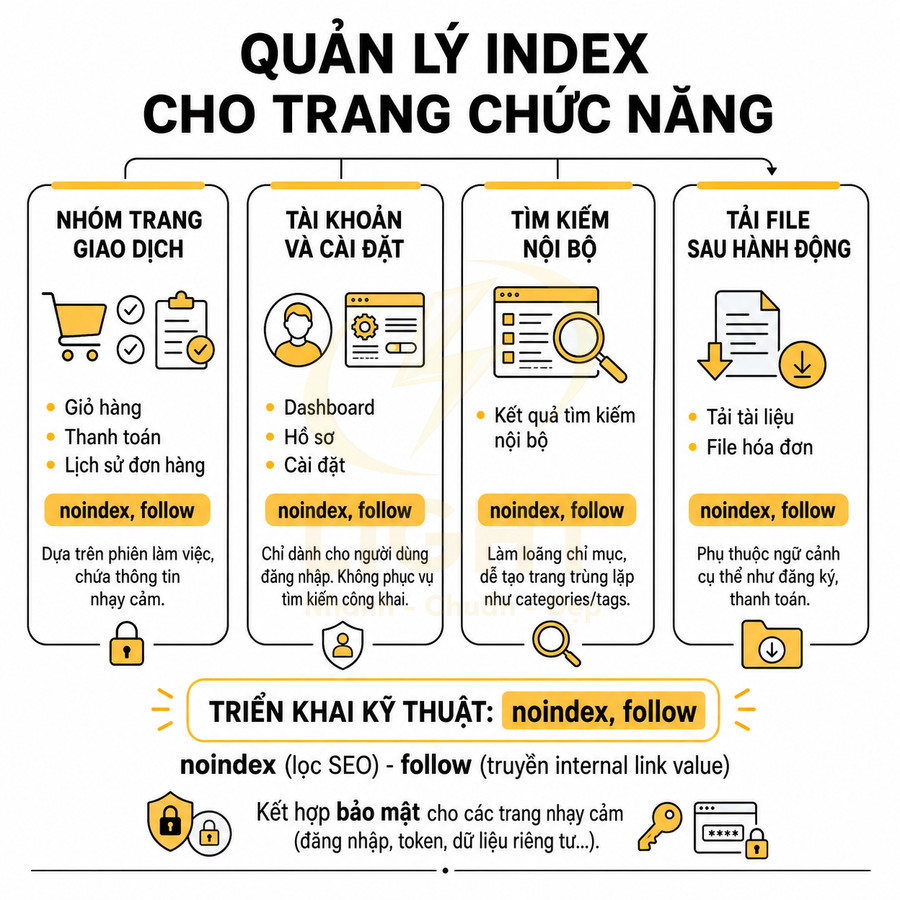
Các ví dụ điển hình và phân tích sâu hơn:
- Trang giỏ hàng, checkout, lịch sử đơn hàng:
- Giỏ hàng:
- Nội dung phụ thuộc hoàn toàn vào session người dùng.
- Truy cập trực tiếp từ Google thường dẫn đến giỏ hàng trống, gây trải nghiệm kém.
- Checkout:
- Thường yêu cầu trạng thái trước đó (giỏ hàng đã có sản phẩm, thông tin đã được nhập một phần).
- Có thể chứa thông tin nhạy cảm (địa chỉ, phương thức thanh toán) nên càng không nên xuất hiện trên SERP.
- Lịch sử đơn hàng:
- Gắn với tài khoản cá nhân, chỉ có ý nghĩa sau khi đăng nhập.
- Cần kết hợp noindex với cơ chế bảo mật (bắt buộc login, session, token).
- Giỏ hàng:
- Trang dashboard, profile, cài đặt tài khoản:
- Thuộc nhóm trang “ứng dụng” (app-like), không phải nội dung công khai.
- Không có search intent công khai; người dùng không tìm “cài đặt tài khoản của tôi” trên Google để vào trang của bạn.
- Trang kết quả tìm kiếm nội bộ:
- Cần tồn tại để hỗ trợ người dùng tìm kiếm trong site.
- Không nên index vì:
- Trùng lặp với các trang category, tag, hub nội dung đã được tối ưu SEO.
- Dễ tạo ra vô số URL mỏng, gây loãng chỉ mục.
- Trang tải file sau khi người dùng đã đăng nhập hoặc hoàn thành hành động:
- Ví dụ: trang cảm ơn kèm link tải tài liệu, trang cung cấp file invoice, trang chứa link tải phần mềm dành riêng cho khách hàng.
- Không phù hợp để index vì:
- Thường gắn với ngữ cảnh cụ thể (sau khi đăng ký, sau khi thanh toán).
- Có thể chứa thông tin hoặc tài nguyên chỉ dành cho một nhóm người dùng nhất định.
Nguyên tắc triển khai kỹ thuật:
- Nếu trang cần cho luồng thao tác nhưng không có giá trị khi người dùng vào trực tiếp từ Google, hãy dùng noindex, follow:
- noindex đảm bảo trang không xuất hiện trên SERP.
- follow cho phép bot vẫn đi theo các liên kết trên trang, truyền PageRank và tín hiệu internal link đến các URL khác.
- Nếu trang chứa thông tin nhạy cảm hoặc cá nhân:
- Noindex chỉ là lớp bảo vệ SEO, không phải lớp bảo mật.
- Cần kết hợp:
- Yêu cầu đăng nhập (authentication).
- Phân quyền truy cập (authorization).
- Các cơ chế bảo mật khác (token, IP restriction, mã hóa).
Trang không nằm trong sitemap XML và không được liên kết như trang SEO trọng điểm
Một tiêu chí thực tế và dễ kiểm tra trước khi noindex là xem URL đó có được đối xử như một trang SEO trọng điểm trong kiến trúc thông tin của website hay không. Về mặt kỹ thuật và cấu trúc, các trang SEO quan trọng thường có những đặc điểm nhất quán, trong khi các trang chức năng, trang phụ trợ thì không.
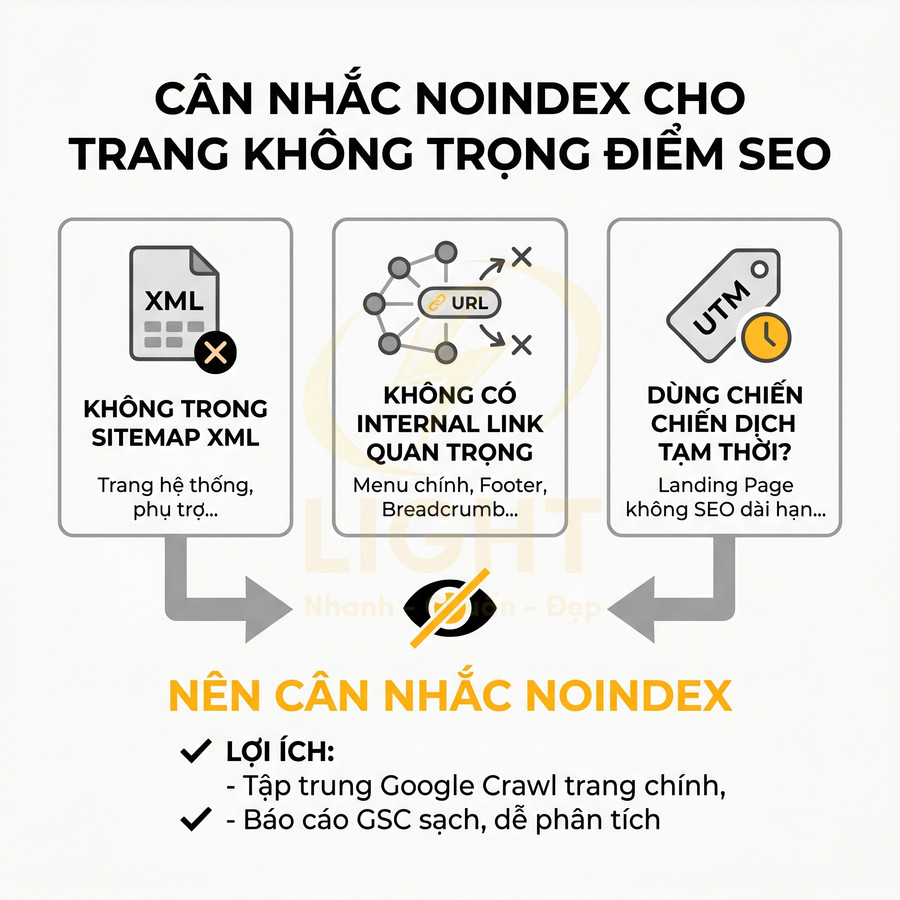
Các bước kiểm tra chi tiết:
- URL có xuất hiện trong sitemap XML không?
- Nếu sitemap được quản lý chuẩn:
- Các trang quan trọng về SEO (category, sản phẩm chính, bài viết, landing page) sẽ luôn có mặt.
- Các trang hệ thống, trang bước trung gian, trang nội bộ thường bị loại trừ.
- Nếu URL không nằm trong sitemap và không có lý do rõ ràng để thêm vào, đó là tín hiệu mạnh cho việc cân nhắc noindex.
- Nếu sitemap được quản lý chuẩn:
- URL có được link từ:
- Menu chính, footer, breadcrumb?
- Menu chính và footer thường chỉ chứa các trang có vai trò chiến lược (SEO, thương hiệu, chuyển đổi).
- Breadcrumb phản ánh vị trí của trang trong cấu trúc nội dung; nếu URL không xuất hiện trong breadcrumb, khả năng cao nó là trang chức năng.
- Trang category, hub nội dung?
- Các hub nội dung thường chỉ liên kết đến các trang mà bạn muốn Google coi là quan trọng.
- Các bài viết hoặc trang SEO khác?
- Nếu không có internal link mang tính biên tập (editorial link) trỏ đến, URL ít có vai trò trong chiến lược nội dung.
- Menu chính, footer, breadcrumb?
- URL có được dùng làm
trong chiến dịch marketing không? - Nếu URL được dùng trong:
- Chiến dịch quảng cáo (Ads, social, email).
- Hoặc là đích đến của các UTM link.
- Cần cân nhắc:
- Nếu chỉ là landing page tạm thời, không cần SEO, có thể noindex nhưng vẫn cho phép truy cập trực tiếp.
- Nếu là landing page dài hạn, có thể tối ưu để vừa phục vụ campaign vừa có giá trị SEO.
- Nếu URL được dùng trong:
Nếu URL không có vai trò trong cấu trúc SEO (không nằm trong sitemap, không được internal link như một node quan trọng, không phải landing page chiến dịch dài hạn) và chỉ phục vụ chức năng nội bộ, noindex giúp Google tập trung crawl và index các URL quan trọng hơn, đồng thời giữ cho báo cáo index trong GSC sạch, dễ phân tích và dễ phát hiện vấn đề.
Meta robots, canonical, robots.txt và status code không xung đột nhau
Trước khi áp dụng noindex, cần đảm bảo không có xung đột tín hiệu giữa các thành phần kỹ thuật chính: meta robots, canonical, robots.txt và status code. Một URL chuẩn SEO nên có trạng thái rõ ràng, nhất quán, tránh gửi thông điệp mâu thuẫn khiến Google phải “đoán” ý định của bạn.
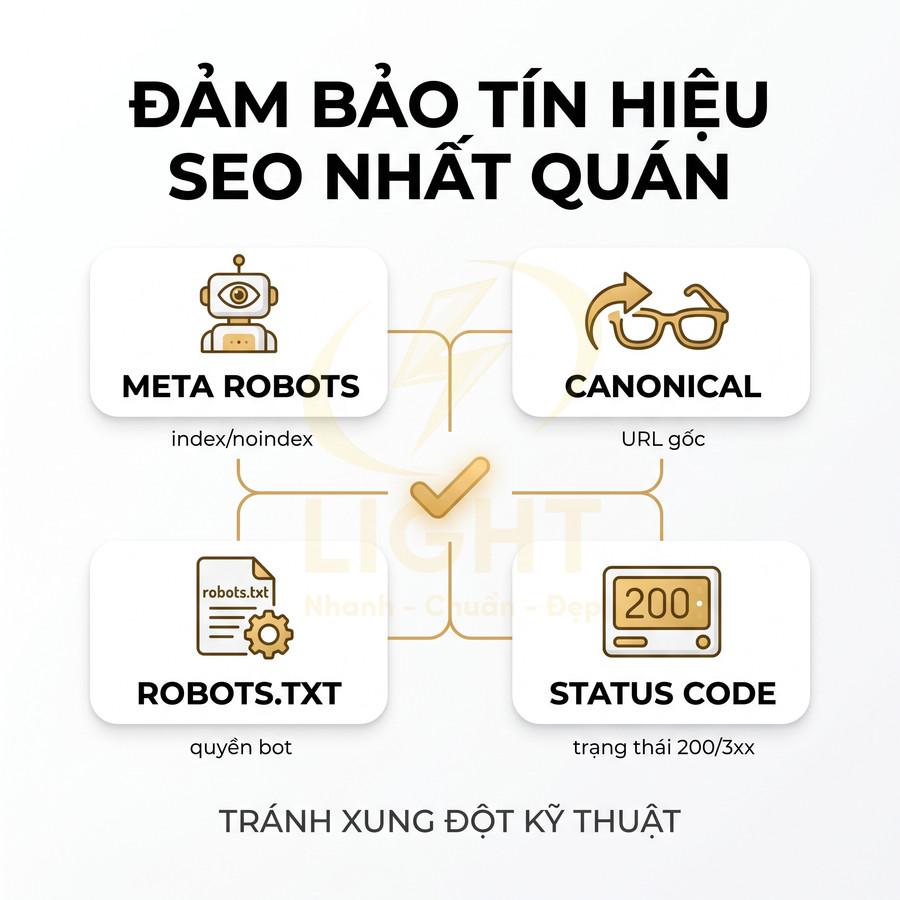
Checklist kỹ thuật chi tiết:
- Meta robots:
- Chỉ có một thẻ meta robots trong <head> với giá trị rõ ràng:
- index, follow cho trang muốn index.
- noindex, follow cho trang muốn loại khỏi chỉ mục nhưng vẫn cho bot đi theo link.
- Tránh:
- Nhiều thẻ meta robots với giá trị khác nhau (ví dụ: một thẻ index, một thẻ noindex).
- Xung đột giữa meta robots và HTTP header (X-Robots-Tag).
- Chỉ có một thẻ meta robots trong <head> với giá trị rõ ràng:
- Canonical:
- Nếu URL noindex, cần xem lại chiến lược canonical:
- Noindex + canonical đến URL index khác:
- Phù hợp khi URL là bản phụ (duplicate/near-duplicate) của một trang chính.
- Giúp hợp nhất tín hiệu (link, tín hiệu người dùng) về URL canonical.
- Chỉ canonical, không noindex:
- Phù hợp khi muốn Google tập trung vào URL canonical nhưng vẫn cho phép bản phụ được crawl và hiểu ngữ cảnh.
- Noindex + canonical đến URL index khác:
- Tránh:
- Noindex nhưng canonical trỏ đến chính nó trong khi bạn lại mong muốn index.
- Noindex + canonical trỏ đến một URL mà bạn không muốn nhận tín hiệu từ trang này.
- Nếu URL noindex, cần xem lại chiến lược canonical:
- robots.txt:
- Không disallow URL trong robots.txt nếu mục tiêu là để Google:
- Truy cập trang.
- Đọc thẻ noindex.
- Và sau đó loại trang khỏi chỉ mục.
- Nếu chặn bằng robots.txt, Google có thể vẫn giữ URL trong chỉ mục dựa trên tín hiệu bên ngoài (backlink, anchor text), nhưng không thể cập nhật trạng thái noindex.
- Không disallow URL trong robots.txt nếu mục tiêu là để Google:
- Status code:
- URL noindex nên trả về 200 (OK) trong trường hợp trang vẫn tồn tại và hoạt động bình thường.
- Hoặc 3xx nếu bạn quyết định redirect:
- 301/308 cho chuyển hướng vĩnh viễn.
- 302/307 cho chuyển hướng tạm thời.
- Nếu trả về 4xx/5xx:
- Noindex gần như không còn ý nghĩa, vì Google sẽ xử lý URL như lỗi hoặc không tồn tại.
- Trong trường hợp 404/410, Google sẽ dần loại URL khỏi chỉ mục mà không cần noindex.
Việc đảm bảo các tín hiệu này không xung đột giúp Google hiểu rõ ý định của bạn, giảm rủi ro xử lý sai (ví dụ: index nhầm trang không mong muốn, bỏ sót trang quan trọng) và giúp website vận hành ổn định, dễ kiểm soát hơn về mặt SEO kỹ thuật.
Cách theo dõi hiệu quả sau khi triển khai noindex
Sau khi triển khai noindex, cần xây dựng quy trình theo dõi liên tục để đảm bảo Google hiểu đúng và áp dụng chính xác các rule. Trước hết, sử dụng URL Inspection trong Google Search Console để xác nhận trạng thái từng URL, kiểm tra HTML đã render, meta robots, header X-Robots-Tag và các yếu tố có thể xung đột như canonical, redirect hay robots.txt. Tiếp theo, theo dõi báo cáo Page indexing theo thời gian, phân tích theo sitemap và pattern URL để đánh giá mức độ bao phủ noindex, phát hiện sớm việc noindex nhầm nhóm trang quan trọng. Song song, giám sát traffic, ranking, crawl stats và thiết lập alert tự động để nhận diện bất thường. Cuối cùng, thường xuyên cập nhật rule noindex khi taxonomy, sản phẩm, nội dung hoặc chiến lược SEO thay đổi, có tài liệu hóa, review định kỳ và kiểm thử kỹ trước khi rollout rộng.
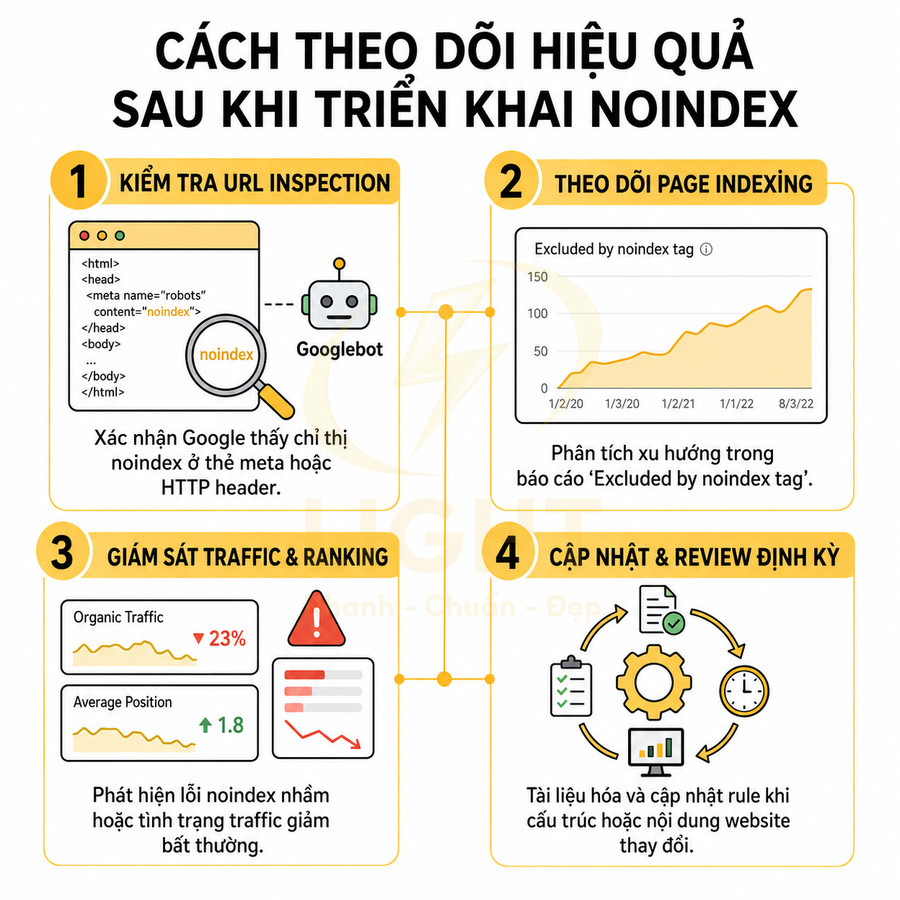
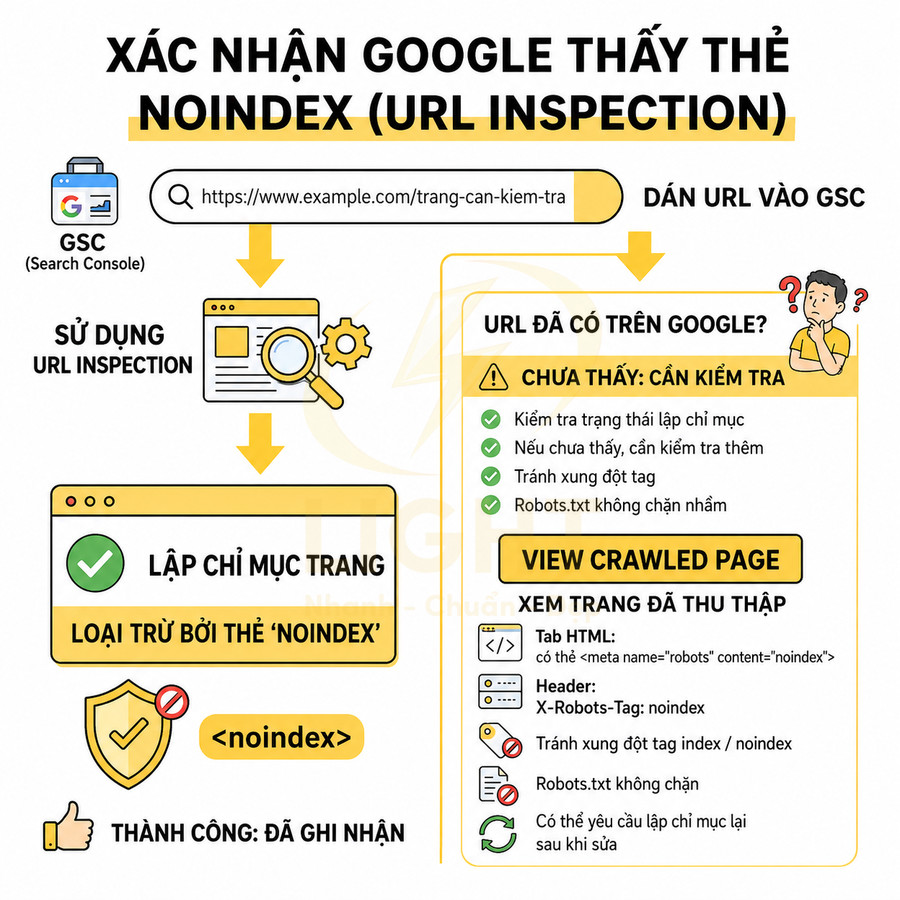
Kiểm tra URL Inspection để xác nhận Google đã thấy thẻ noindex
Sau khi triển khai noindex, bước quan trọng nhất là đảm bảo Google thực sự crawl lại và ghi nhận chính xác tín hiệu noindex. Nếu chỉ thêm thẻ mà không được Googlebot thu thập lại, URL vẫn có thể tiếp tục xuất hiện trong kết quả tìm kiếm một thời gian dài.
Công cụ URL Inspection trong Google Search Console (GSC) là kênh kiểm tra trực tiếp trạng thái từng URL ở mức kỹ thuật. Ngoài việc xem trạng thái index, cần đi sâu hơn vào phần HTML đã được Googlebot render để chắc chắn thẻ noindex được áp dụng đúng vị trí, đúng cú pháp và không bị override bởi các directive khác.
- Các bước kiểm tra chi tiết:
- Dán URL cần kiểm tra vào ô “Inspect any URL in…” trong GSC, ưu tiên:
- Một vài URL đại diện cho từng nhóm rule noindex (filter, search, tag, v.v.).
- Các URL quan trọng mà bạn chắc chắn không muốn noindex để phát hiện lỗi sớm.
- Quan sát phần Page indexing:
- Nếu hiển thị “Excluded by ‘noindex’ tag”, nghĩa là:
- Google đã crawl lại sau khi bạn triển khai noindex.
- Directive noindex được hiểu đúng (qua meta robots hoặc X-Robots-Tag).
- Nếu vẫn hiển thị “URL is on Google”:
- Có thể Google chưa crawl lại URL sau khi bạn thêm noindex (thường gặp với URL ít traffic, ít internal link).
- Hoặc thẻ noindex chưa được render đúng (ví dụ: bị chèn qua JavaScript nhưng Google không render, hoặc nằm sai vị trí trong HTML).
- Nếu hiển thị “Excluded by ‘noindex’ tag”, nghĩa là:
- Sử dụng “View Crawled Page”:
- Kiểm tra tab HTML:
- Xác nhận có thẻ:
<meta name="robots" content="noindex,follow">hoặc biến thể tương đương.- Hoặc header X-Robots-Tag với giá trị
noindexnếu bạn set qua server.
- Đảm bảo không có thẻ meta robots khác mâu thuẫn (ví dụ: một thẻ
index,followvà một thẻnoindexcùng tồn tại).
- Xác nhận có thẻ:
- Kiểm tra tab More info (nếu có):
- Xem Google có phát hiện redirect, canonical, hay lỗi HTTP bất thường không.
- Đảm bảo URL không bị block bởi robots.txt, vì nếu bị block, Google có thể không đọc được thẻ noindex trong HTML.
- Kiểm tra tab HTML:
- Nếu cần đẩy nhanh quá trình:
- Dùng “Request indexing” cho:
- Các URL nhạy cảm (ví dụ: trang test, staging, trang có thông tin nhạy cảm cần gỡ khỏi index nhanh).
- Một mẫu nhỏ URL đại diện để xác nhận rule noindex hoạt động đúng trước khi rollout diện rộng.
- Với số lượng lớn URL, nên để Google tự crawl theo lịch trình tự nhiên, tránh spam request indexing gây lãng phí tài nguyên và không mang lại lợi ích đáng kể.
- Dùng “Request indexing” cho:
- Dán URL cần kiểm tra vào ô “Inspect any URL in…” trong GSC, ưu tiên:
- Lưu ý kỹ thuật nâng cao:
- Nếu dùng framework render phía client (SPA), cần đảm bảo:
- Thẻ noindex xuất hiện trong HTML đã được prerender hoặc SSR, không chỉ trong DOM sau khi JS chạy.
- Kiểm tra bằng “View Crawled Page” thay vì chỉ xem source trên trình duyệt.
- Nếu set noindex qua HTTP header:
- Kiểm tra log server hoặc dùng công cụ như curl, Chrome DevTools > Network để xác nhận header X-Robots-Tag được trả về đúng cho từng loại file (HTML, PDF, image, v.v.).
- Nếu dùng framework render phía client (SPA), cần đảm bảo:
Theo dõi Page indexing trong Google Search Console sau các lần crawl mới
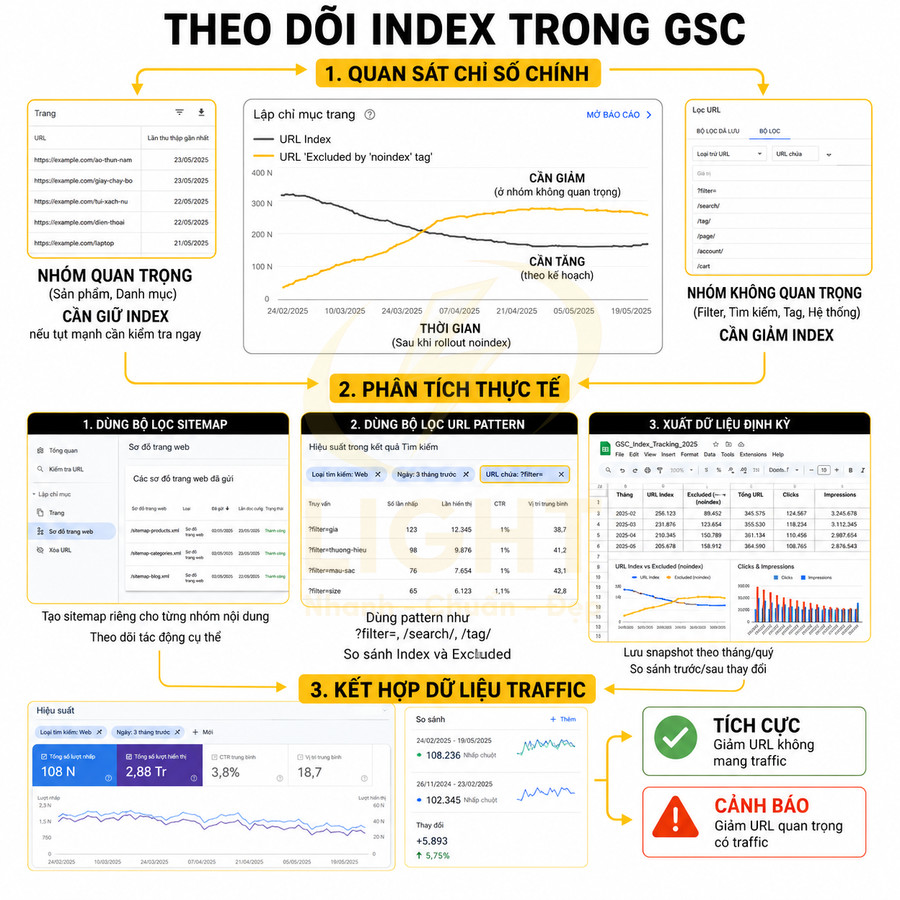
Báo cáo Page indexing trong GSC không chỉ cho biết số lượng URL được index hay bị loại trừ, mà còn giúp đánh giá tính nhất quán giữa chiến lược noindex và trạng thái thực tế trên Google. Việc theo dõi theo thời gian cho phép bạn phát hiện sớm các sai lệch, ví dụ: rule noindex áp dụng quá rộng hoặc không áp dụng đủ.
- Các chỉ số cần quan sát sau khi triển khai noindex:
- Số lượng URL trong nhóm “Excluded by ‘noindex’ tag”:
- Nên tăng dần theo đúng kế hoạch rollout.
- Nếu tăng quá nhanh hoặc vượt xa số lượng dự kiến, có thể bạn đã noindex nhầm một nhóm lớn URL.
- Số lượng URL index trong các nhóm không quan trọng:
- Filter, search result, trang hệ thống, trang duplicate nên giảm dần.
- Nếu không giảm, có thể:
- Google chưa crawl lại đủ nhanh.
- Hoặc rule noindex chưa áp dụng đúng pattern URL.
- Số lượng URL index trong nhóm quan trọng (product, category, landing page):
- Không nên có sự sụt giảm bất thường.
- Nếu giảm mạnh, cần kiểm tra ngay rule noindex, canonical, redirect và robots.txt.
- Số lượng URL trong nhóm “Excluded by ‘noindex’ tag”:
- Cách phân tích thực tế trong GSC:
- Sử dụng bộ lọc theo sitemap:
- Tạo sitemap riêng cho:
- Product, category, landing page quan trọng.
- Các nhóm nội dung phụ (blog, tag, filter, v.v.).
- Lọc báo cáo Page indexing theo từng sitemap để:
- Đo lường tác động của noindex trên từng nhóm.
- Đảm bảo sitemap “core” không bị giảm index bất thường.
- Tạo sitemap riêng cho:
- Lọc theo pattern URL:
- Dùng chức năng filter URL chứa một đoạn path nhất định (ví dụ:
?filter=,/search/,/tag/). - So sánh số lượng URL index vs excluded by noindex trong từng pattern để đánh giá mức độ bao phủ của rule.
- Dùng chức năng filter URL chứa một đoạn path nhất định (ví dụ:
- Xuất dữ liệu định kỳ:
- Thiết lập chu kỳ export (ví dụ: hàng tháng hoặc hàng quý) để:
- Lưu lại snapshot số lượng URL index/excluded theo từng nhóm.
- So sánh trước và sau mỗi lần thay đổi rule noindex hoặc cấu trúc site.
- Có thể kết hợp với Google Looker Studio hoặc BI nội bộ để trực quan hóa xu hướng.
- Thiết lập chu kỳ export (ví dụ: hàng tháng hoặc hàng quý) để:
- Kết hợp với dữ liệu traffic:
- Mapping nhóm URL trong GSC với:
- Organic sessions, conversion, revenue/lead từ Google Analytics hoặc hệ thống tracking khác.
- Nếu số URL index giảm ở nhóm không mang lại traffic/conversion, đó là tín hiệu tích cực (giảm “noise” trong index).
- Nếu số URL index giảm ở nhóm mang lại nhiều traffic/conversion, cần điều tra nguyên nhân ngay.
- Mapping nhóm URL trong GSC với:
- Sử dụng bộ lọc theo sitemap:
Giám sát traffic, ranking và crawl stats để phát hiện noindex nhầm trang quan trọng
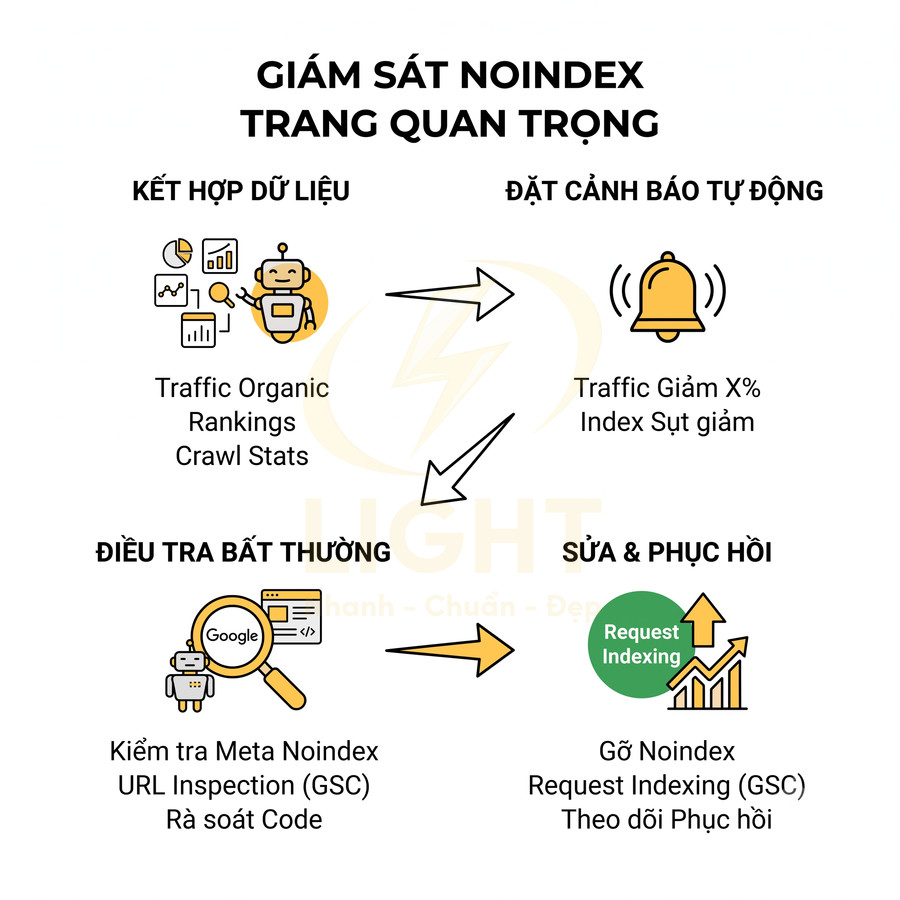
Noindex nhầm các trang quan trọng thường gây ra thiệt hại lớn về organic traffic và doanh thu. Vấn đề nghiêm trọng hơn là lỗi này đôi khi không được phát hiện ngay nếu không có hệ thống giám sát chủ động. Do đó, cần kết hợp nhiều nguồn dữ liệu: traffic, ranking, index status và crawl stats để phát hiện bất thường. Sau khi triển khai noindex, cần xác định trước quy mô URL dự kiến bị ảnh hưởng, nhóm URL được phép giảm index và nhóm URL tuyệt đối không được mất hiển thị. Việc theo dõi nên kết hợp số URL bị loại khỏi chỉ mục, organic clicks, impressions, thứ hạng nhóm từ khóa, chuyển đổi và tần suất bot crawl theo từng thư mục hoặc loại template. Nghiên cứu về crawling nội dung có tính thời điểm cho thấy chiến lược thu thập hiệu quả phụ thuộc vào việc cân đối giữa tái crawl nguồn hiện có và phát hiện nội dung mới dựa trên tín hiệu nhu cầu người dùng. Do đó, một biến động index không nên được đọc tách rời khỏi biến động traffic và hành vi crawl. Khi lượng URL noindex tăng vượt kế hoạch hoặc traffic giảm ở nhóm danh mục, sản phẩm hay landing page, cần kiểm tra ngay rule template, middleware, header và cache trước khi suy đoán do thuật toán (Lefortier et al., 2014).
- Các dấu hiệu cảnh báo sớm:
- Traffic organic:
- Giảm đột ngột ở một nhóm URL (ví dụ: toàn bộ product của một brand, một category, hoặc toàn bộ blog).
- Giảm không trùng với thời điểm update thuật toán lớn, mùa vụ, hay thay đổi chiến dịch marketing.
- Thứ hạng từ khóa:
- Nhiều từ khóa chính tụt mạnh, đặc biệt khi:
- URL đích chuyển từ trạng thái “index” sang “excluded by noindex”.
- Google bắt đầu hiển thị URL khác (ít liên quan hơn) cho cùng từ khóa.
- Nhiều từ khóa chính tụt mạnh, đặc biệt khi:
- Crawl stats:
- Google giảm crawl rate cho các directory vốn là landing page chính (ví dụ:
/products/,/services/). - Tỷ lệ crawl chuyển dịch sang các URL phụ, trong khi URL quan trọng ít được truy cập.
- Google giảm crawl rate cho các directory vốn là landing page chính (ví dụ:
- Traffic organic:
- Thiết lập hệ thống giám sát và dashboard:
- Kết hợp dữ liệu:
- Organic sessions, revenue/lead:
- Phân nhóm theo directory, template, hoặc type (product, category, blog, v.v.).
- Number of indexed pages (từ GSC):
- Theo sitemap hoặc pattern URL tương ứng với các nhóm trên.
- Crawl stats:
- Từ GSC (Crawl stats report) hoặc log server để biết Googlebot truy cập những URL nào, với tần suất ra sao.
- Organic sessions, revenue/lead:
- Đặt alert tự động:
- Traffic:
- Cảnh báo khi traffic organic của nhóm URL quan trọng giảm quá ngưỡng X% trong Y ngày liên tiếp.
- Có thể dùng công cụ như GA custom alerts, hệ thống BI, hoặc script nội bộ.
- Index status:
- Cảnh báo khi số lượng URL index trong sitemap chính giảm bất thường trong một khoảng thời gian ngắn.
- Có thể theo dõi qua API GSC và so sánh với baseline.
- Traffic:
- Quy trình điều tra khi phát hiện bất thường:
- Kiểm tra meta robots:
- Lấy mẫu URL bị ảnh hưởng, dùng:
- URL Inspection trong GSC.
- Công cụ crawl (Screaming Frog, Sitebulb, v.v.) để quét hàng loạt và lọc theo meta robots chứa
noindex.
- Lấy mẫu URL bị ảnh hưởng, dùng:
- Rà soát thay đổi gần đây:
- Code base (deploy mới, thay đổi template, update plugin SEO).
- Cấu hình server (thêm rule X-Robots-Tag, thay đổi redirect, cấu hình cache/CDN).
- Các rule condition theo taxonomy, language, location có thể vô tình áp dụng noindex cho nhóm URL rộng hơn dự kiến.
- Sau khi sửa:
- Gỡ noindex khỏi các trang quan trọng.
- Dùng “Request indexing” cho một số URL đại diện để đẩy nhanh việc phục hồi index.
- Theo dõi lại traffic và ranking trong vài tuần tiếp theo để đánh giá mức độ phục hồi.
- Kiểm tra meta robots:
- Kết hợp dữ liệu:
Cập nhật rule noindex khi taxonomy, sản phẩm, nội dung hoặc chiến lược SEO thay đổi
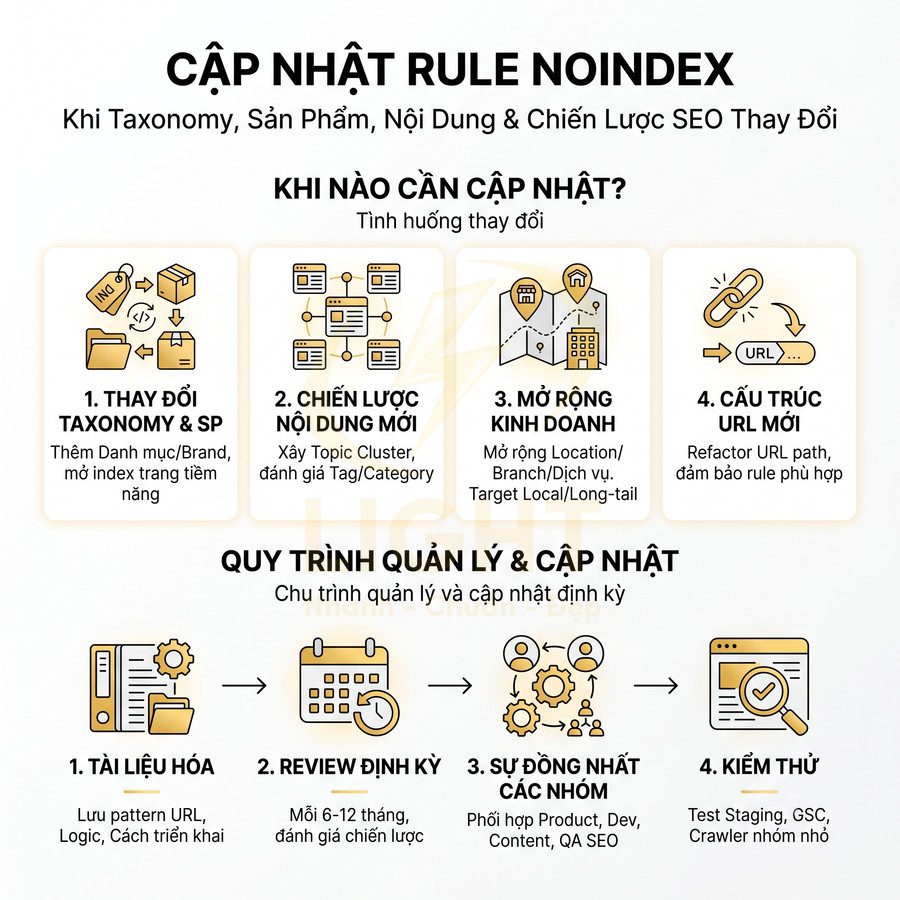
Chiến lược noindex là một phần của kiến trúc SEO tổng thể và phải được xem như một hệ thống động. Khi taxonomy, danh mục sản phẩm, chiến lược nội dung hoặc mục tiêu kinh doanh thay đổi, các rule noindex cũ có thể trở nên lỗi thời, gây lãng phí cơ hội hoặc thậm chí chặn index những khu vực mới quan trọng.
- Các tình huống cần xem lại rule noindex:
- Thêm danh mục mới có search intent rõ ràng:
- Ví dụ: trước đây bạn noindex toàn bộ trang brand hoặc tag, nhưng nay muốn khai thác từ khóa theo brand/tag.
- Cần:
- Xác định nhóm trang nào nên chuyển từ noindex sang index.
- Điều chỉnh rule để không áp dụng noindex cho các danh mục mới có tiềm năng traffic.
- Thay đổi chiến lược nội dung:
- Ví dụ: trước đây blog chỉ là hỗ trợ, nhiều tag/category bị noindex; nay muốn xây cụm chủ đề (topic cluster) dựa trên tag.
- Cần:
- Đánh giá lại từng nhóm tag/category theo search volume, intent, khả năng chuyển đổi.
- Mở index cho các nhóm có tiềm năng, giữ noindex cho nhóm mỏng nội dung hoặc trùng lặp.
- Thay đổi mô hình kinh doanh:
- Mở rộng sang thị trường mới, thêm location, branch, service line.
- Các trang location, branch, service-specific có thể cần được index để target truy vấn local hoặc long-tail.
- Đảm bảo rule noindex cũ (ví dụ: noindex toàn bộ URL chứa
?location=) không chặn các trang mới quan trọng.
- Refactor URL structure:
- Thay đổi path (ví dụ: từ
/category/sang/c/, từ/blog/sang/insights/). - Các rule noindex dựa trên pattern cũ có thể:
- Không còn tác dụng với URL mới (khiến nhiều trang phụ bị index trở lại).
- Hoặc vô tình áp dụng cho path mới nếu dùng regex hoặc rule quá rộng.
- Thay đổi path (ví dụ: từ
- Thêm danh mục mới có search intent rõ ràng:
- Quy trình quản lý và cập nhật rule noindex:
- Tài liệu hóa rule noindex:
- Lưu trữ như một phần của tài liệu kiến trúc SEO:
- Danh sách pattern URL được noindex.
- Logic điều kiện (theo taxonomy, template, loại nội dung, ngôn ngữ, v.v.).
- Cách triển khai (meta robots, X-Robots-Tag, plugin SEO, middleware, v.v.).
- Cập nhật tài liệu mỗi khi:
- Thêm, sửa, xóa rule noindex.
- Thay đổi cấu trúc URL hoặc template.
- Lưu trữ như một phần của tài liệu kiến trúc SEO:
- Review định kỳ:
- Thiết lập chu kỳ review (6–12 tháng) để:
- Đánh giá lại các nhóm đang noindex xem còn phù hợp với chiến lược SEO và kinh doanh hiện tại không.
- Phát hiện các cơ hội mới (nhóm trang đang noindex nhưng có tiềm năng mang lại traffic/conversion).
- Kết hợp dữ liệu:
- Search demand (keyword research).
- Performance hiện tại của các nhóm tương tự đang index.
- Thiết lập chu kỳ review (6–12 tháng) để:
- Đảm bảo alignment giữa các team:
- Product:
- Hiểu nguyên tắc noindex để khi thiết kế tính năng mới (filter, personalization, A/B test) không tạo ra hàng loạt URL indexable không cần thiết.
- Dev:
- Nắm rõ cách implement noindex (meta vs header) và các edge case (SPA, SSR, caching, CDN).
- Đảm bảo mọi thay đổi code liên quan đến template, header, middleware đều được QA SEO kiểm tra.
- Content/Marketing:
- Biết nhóm nội dung nào được phép index, nhóm nào mặc định noindex.
- Không tự ý bật/tắt noindex trong CMS mà không có quy trình review.
- Product:
- Kiểm thử trước khi rollout:
- Triển khai rule noindex mới trên:
- Staging hoặc môi trường test (nếu có) để kiểm tra logic.
- Một nhóm nhỏ URL trên production, sau đó:
- Dùng crawler để xác nhận meta robots/X-Robots-Tag.
- Dùng GSC URL Inspection cho một số URL mẫu.
- Sau khi chắc chắn rule hoạt động đúng, mới mở rộng phạm vi áp dụng.
- Triển khai rule noindex mới trên:
- Tài liệu hóa rule noindex:
Câu hỏi thường gặp về noindex và website chuẩn SEO
Noindex là công cụ kiểm soát chỉ mục, không phải “xóa PageRank”, nhưng có thể ảnh hưởng đến cách tín hiệu liên kết được phân phối và tần suất crawl toàn site. Việc dùng noindex, follow thường phù hợp cho các trang hệ thống, tag, filter, search nội bộ, giúp vẫn duy trì luồng internal link. Ngược lại, noindex, nofollow chỉ nên áp dụng cho khu vực nhạy cảm, spam, hoặc cấu trúc dễ gây lãng phí crawl budget.
Trong thực hành chuẩn SEO, URL noindex không nên nằm trong sitemap để tránh mixed signals và lãng phí crawl. Cần hiểu rõ sự khác biệt giữa noindex và nofollow, cách kết hợp với canonical, cũng như thời gian Google loại trang noindex khỏi SERP để xây dựng chiến lược tối ưu, đồng thời giữ index cho các trang tăng EEAT như giới thiệu, liên hệ.
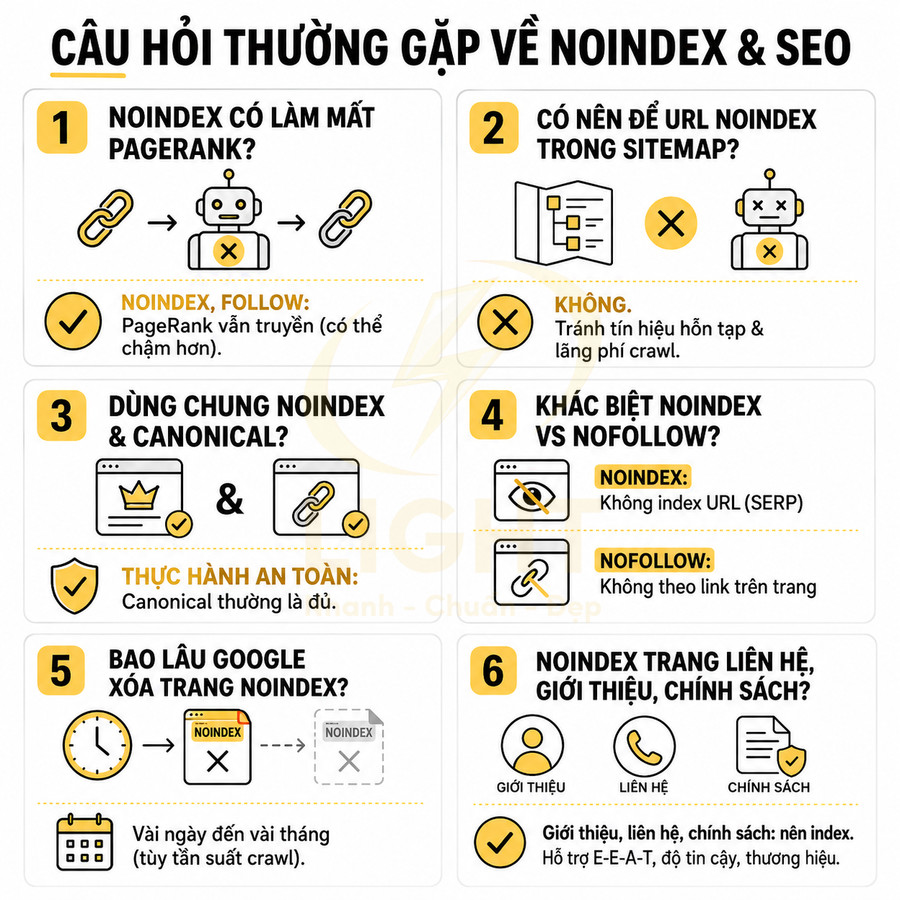
Noindex có làm mất PageRank của trang không?
Noindex không trực tiếp “xóa” PageRank của một URL, nhưng ảnh hưởng khá sâu đến cách PageRank được tích lũy, bảo toàn và phân phối trong toàn bộ cấu trúc website. Khi một trang được gắn noindex, follow, Google vẫn có thể crawl trang đó, đọc nội dung và theo các link ra ngoài, nên tín hiệu liên kết (link signals) vẫn có khả năng được truyền. Tuy nhiên, về mặt thực thi, có một số lớp tác động kỹ thuật cần hiểu rõ hơn.
Về cơ chế:
- PageRank được phân phối thông qua các liên kết nội bộ và external link. Một URL bị noindex:
- Vẫn có thể nhận PageRank từ các backlink trỏ đến.
- Vẫn có thể truyền PageRank ra ngoài nếu dùng noindex, follow.
- Có thể bị giảm tần suất crawl theo thời gian nếu Google đánh giá trang đó ít giá trị cho chỉ mục.
- Khi tần suất crawl giảm:
- Google ít “refresh” dữ liệu về các link trên trang.
- Việc truyền tín hiệu liên kết có thể chậm hơn, không còn “real-time” như các trang quan trọng khác.
Một số kịch bản chuyên sâu cần lưu ý:
- Trang noindex có nhiều backlink chất lượng, anchor text tốt:
- Giữ noindex lâu dài có thể khiến bạn không tận dụng tối đa giá trị của các backlink này trong chiến lược tổng thể.
- Giải pháp thường được khuyến nghị:
- Chuyển sang index, tối ưu nội dung để trang có thể tự rank cho các truy vấn liên quan.
- Hoặc dùng 301 redirect sang một URL index khác có nội dung tương đương hoặc tốt hơn để hợp nhất PageRank và các tín hiệu liên quan (anchor text, lịch sử tương tác).
- Trang noindex là trang hệ thống, không có hoặc rất ít backlink:
- Ví dụ: trang lọc nâng cao, trang kết quả tìm kiếm nội bộ, trang bước trung gian trong funnel.
- Việc noindex gần như không gây mất mát đáng kể về PageRank ở cấp độ toàn site, miễn là:
- Các trang quan trọng vẫn được liên kết trực tiếp từ menu, category, internal link khác.
- Không “nhốt” PageRank trong các cụm trang noindex, nofollow.
- Dùng noindex, nofollow:
- Khi gắn noindex, nofollow, bạn đang:
- Yêu cầu Google không index URL hiện tại.
- Hạn chế hoặc chặn việc Google theo các link trên trang, từ đó hạn chế truyền PageRank qua trang đó.
- Chỉ nên dùng trong các trường hợp:
- Trang chứa nội dung nhạy cảm, spam, hoặc khu vực private.
- Trang có cấu trúc link có thể gây lãng phí crawl budget (ví dụ: infinite faceted navigation, filter vô hạn).
- Khi gắn noindex, nofollow, bạn đang:
Về chiến lược SEO tổng thể, nên xem noindex như một công cụ điều tiết chỉ mục và crawl budget, không phải công cụ “xóa PageRank”. Quyết định noindex cần gắn với:
- Vai trò của URL trong funnel chuyển đổi.
- Giá trị backlink trỏ đến URL đó.
- Khả năng thay thế bằng 301 redirect hoặc hợp nhất nội dung.
Trang noindex có nên để trong sitemap XML không?
Về nguyên tắc kỹ thuật, sitemap XML là “danh sách ưu tiên” các URL mà bạn muốn Google crawl và index. Do đó, việc đưa URL noindex vào sitemap tạo ra một tín hiệu mâu thuẫn: sitemap “mời” index, trong khi meta robots lại “từ chối” index.
Các tác động chuyên môn:
- Tín hiệu hỗn tạp (mixed signals):
- Sitemap nói: “URL này quan trọng, hãy crawl và index”.
- Meta robots noindex nói: “Đừng index URL này”.
- Google thường tôn trọng noindex, nhưng sự mâu thuẫn có thể khiến hệ thống đánh giá lại mức độ tin cậy của sitemap.
- Lãng phí crawl budget:
- Mỗi lần Googlebot truy cập sitemap, nó sẽ thấy các URL noindex và có thể vẫn phải crawl để xác nhận trạng thái.
- Với site lớn, hàng chục nghìn URL noindex trong sitemap có thể tiêu tốn crawl budget đáng kể, làm chậm việc crawl các trang quan trọng.
Một số ngoại lệ hiếm gặp có thể cân nhắc:
- Khi bạn tạm thời noindex một nhóm URL:
- Ví dụ: đang xử lý vấn đề nội dung trùng lặp, thin content, hoặc audit nội dung.
- Dự định sẽ mở lại index trong thời gian ngắn (vài tuần).
- Ngay cả trong trường hợp này, nhiều chuyên gia vẫn khuyến nghị:
- Loại khỏi sitemap để giữ tín hiệu rõ ràng, sau đó thêm lại khi bỏ noindex.
Trong thực hành chuẩn SEO, quy tắc an toàn:
- Không đưa URL noindex vào sitemap.
- Khi chuyển một URL từ index sang noindex:
- Cập nhật logic sinh sitemap (code, plugin, hoặc hệ thống CMS) để tự động loại bỏ URL đó.
- Đảm bảo không còn bản sitemap cũ cache trên CDN chứa URL noindex.
- Đối với site lớn:
- Có thể duy trì nhiều sitemap tách biệt (content, media, product, v.v.) và đảm bảo chỉ các nhóm URL “được phép index” mới xuất hiện.
Dùng noindex và canonical cùng lúc có nên không?
Kết hợp noindex và canonical trên cùng một URL là chủ đề gây tranh luận vì hai tín hiệu này có thể được hiểu là “cạnh tranh ưu tiên”. Về mặt lý thuyết:
- Canonical nói với Google: “Hãy coi URL kia là bản chính, hợp nhất tín hiệu về đó”.
- Noindex nói: “Đừng index URL này trong chỉ mục”.
Khi dùng cùng lúc, bạn đang gửi hai thông điệp:
- Đừng index URL hiện tại.
- Nếu muốn index nội dung tương đương, hãy index URL canonical.
Trong thực tế, Google có thể:
- Tôn trọng canonical, coi URL canonical là bản chính và index bản đó.
- Hoặc ưu tiên noindex, dẫn đến việc cả bản phụ lẫn bản chính không được xử lý như mong muốn, đặc biệt nếu canonical bị coi là “self-referential” hoặc không đủ rõ ràng.
Thực hành an toàn trong các kịch bản cụ thể:
- Mục tiêu: hợp nhất nội dung trùng lặp, phiên bản gần giống:
- Ví dụ: URL có tham số filter, sort, tracking; phiên bản HTTP/HTTPS; phiên bản có/không có slash.
- Dùng canonical từ bản phụ sang bản chính:
- Giữ index cho cả hai nếu không có lý do đặc biệt phải ẩn bản phụ.
- Google sẽ dần dồn tín hiệu về bản canonical, bản phụ ít khi xuất hiện trên SERP.
- Không cần noindex, trừ khi:
- Bản phụ thực sự không muốn xuất hiện trong bất kỳ trường hợp nào (ví dụ: trang kết quả tìm kiếm nội bộ trùng lặp với category).
- Mục tiêu: loại bỏ hoàn toàn URL khỏi chỉ mục, không có bản chính khác:
- Dùng noindex (hoặc 404/410 nếu URL không còn lý do tồn tại).
- Không cần canonical, vì không có URL đích để hợp nhất tín hiệu.
- Với nội dung hết hạn (expired content), có thể:
- 301 redirect sang trang danh mục hoặc trang nội dung liên quan nếu muốn giữ tín hiệu.
- Hoặc 410 nếu muốn báo rõ là nội dung đã bị xóa vĩnh viễn.
- Trường hợp buộc phải dùng cả noindex và canonical:
- Ví dụ: bản phụ không muốn index nhưng vẫn muốn dồn tín hiệu về bản chính:
- Trang landing A/B test, bản test không muốn index.
- Trang phiên bản in (print version) của bài viết.
- Cần:
- Thiết lập canonical trỏ về bản chính.
- Gắn noindex trên bản phụ.
- Theo dõi trong Google Search Console:
- Kiểm tra mục “Pages” > “Why pages aren’t indexed”.
- Xem Google đang coi canonical nào là “Selected canonical”.
- Ví dụ: bản phụ không muốn index nhưng vẫn muốn dồn tín hiệu về bản chính:
Noindex khác nofollow như thế nào?
Noindex và nofollow là hai chỉ thị trong meta robots hoặc X-Robots-Tag, với mục đích và tác động khác nhau. Việc hiểu sai hai thuộc tính này có thể dẫn đến cấu hình gây mất tín hiệu liên kết hoặc lãng phí crawl budget.
| Thuộc tính | Mục đích | Tác động chính |
|---|---|---|
| noindex | Yêu cầu không đưa URL vào chỉ mục | Trang không xuất hiện trên SERP (sau khi Google xử lý) |
| nofollow | Yêu cầu không theo các link trên trang | Google có thể không crawl hoặc không truyền tín hiệu qua link |
Các điểm khác biệt quan trọng ở mức kỹ thuật:
- noindex tập trung vào URL hiện tại:
- Google vẫn cần crawl trang để “nhìn thấy” thẻ noindex.
- Sau khi xử lý, URL sẽ bị loại khỏi chỉ mục hoặc không được thêm mới.
- Không tự động chặn crawl; chỉ ảnh hưởng đến index.
- nofollow tập trung vào các link trên URL hiện tại:
- Google có thể:
- Không theo các link đó.
- Hoặc vẫn theo trong một số trường hợp để khám phá URL mới, nhưng không dùng link đó như một tín hiệu xếp hạng mạnh.
- Không đảm bảo 100% chặn truyền PageRank, vì Google đã chuyển từ “chỉ thị cứng” sang “hint” trong nhiều bối cảnh.
- Google có thể:
- Các cách kết hợp phổ biến:
- noindex, follow:
- Không index URL hiện tại.
- Vẫn cho phép Google theo link và truyền tín hiệu liên kết.
- Phù hợp cho:
- Trang tag, filter, search nội bộ không muốn index nhưng vẫn muốn hỗ trợ internal linking.
- Trang hệ thống trong funnel (bước 2, bước 3) không cần xuất hiện trên SERP.
- noindex, nofollow:
- Không index URL hiện tại.
- Không muốn Google theo link trên trang (hoặc chỉ theo rất hạn chế).
- Chỉ nên dùng khi:
- Cần hạn chế crawl sâu vào các khu vực phức tạp, dễ gây duplicate hoặc infinite crawl.
- Có lý do đặc biệt về bảo mật, spam, hoặc nội dung không muốn Google khám phá thêm.
- noindex, follow:
Trong đa số trường hợp SEO, noindex, follow là lựa chọn hợp lý cho các trang không muốn index nhưng vẫn muốn giữ luồng internal link và phân phối PageRank hiệu quả.
Bao lâu Google mới xóa trang noindex khỏi kết quả tìm kiếm?
Thời gian để Google xóa một trang noindex khỏi chỉ mục phụ thuộc chủ yếu vào tần suất crawl của URL đó. Google chỉ có thể áp dụng noindex sau khi đã crawl lại trang và “nhìn thấy” chỉ thị noindex.
Một số quan sát thực tế:
- Với URL được crawl thường xuyên:
- Trang chủ, category lớn, sản phẩm hot, bài viết có nhiều traffic.
- Thời gian thường từ vài ngày đến vài tuần.
- Với URL ít được crawl:
- Trang cũ, ít internal link, ít hoặc không có backlink.
- Có thể mất vài tuần đến vài tháng để biến mất hoàn toàn khỏi SERP.
Các yếu tố ảnh hưởng chuyên sâu:
- Mức độ quan trọng trong cấu trúc internal link:
- URL càng gần trang chủ, càng nhiều link từ các trang quan trọng, càng được crawl thường xuyên.
- Số lượng và chất lượng backlink:
- Backlink mạnh có thể khiến Google ưu tiên crawl URL đó hơn.
- Tuy nhiên, nếu noindex kéo dài, Google vẫn sẽ loại khỏi chỉ mục sau vài lần crawl.
- Tổng crawl budget của website:
- Site lớn, crawl budget hạn chế: quá nhiều URL noindex có thể làm chậm quá trình cập nhật.
- Site nhỏ, cấu trúc gọn: thường cập nhật nhanh hơn.
Cách đẩy nhanh quá trình:
- Đảm bảo URL không bị chặn robots.txt:
- Nếu robots.txt chặn, Google không thể truy cập để thấy thẻ noindex.
- Trong trường hợp này, URL có thể vẫn nằm trong chỉ mục dưới dạng “soft result” hoặc chỉ hiển thị URL mà không có snippet.
- Dùng “Request indexing” trong Google Search Console:
- Áp dụng cho một số URL quan trọng cần xử lý nhanh.
- Không nên lạm dụng cho hàng nghìn URL; với số lượng lớn, nên để Google tự crawl.
- Nếu muốn xóa nhanh và dứt điểm:
- Dùng công cụ Remove URLs trong GSC:
- Tạo yêu cầu tạm thời ẩn URL khỏi kết quả tìm kiếm.
- Kết hợp với noindex hoặc 404/410 để đảm bảo khi hết thời hạn ẩn tạm thời, URL vẫn không quay lại chỉ mục.
- Dùng công cụ Remove URLs trong GSC:
Có nên noindex trang liên hệ, giới thiệu hoặc chính sách không?
Trang liên hệ, giới thiệu, chính sách là các trang hệ thống nhưng đóng vai trò quan trọng trong việc xây dựng EEAT (Expertise, Experience, Authoritativeness, Trustworthiness). Quyết định noindex hay không cần dựa trên mục tiêu kinh doanh, loại hình website và chiến lược thương hiệu.
Một số cân nhắc chi tiết:
- Trang giới thiệu (About):
- Thường nên index vì:
- Giúp xây dựng độ tin cậy, thể hiện lịch sử, sứ mệnh, đội ngũ, năng lực chuyên môn.
- Có thể rank cho các truy vấn thương hiệu hoặc “tên công ty + giới thiệu”, “tên thương hiệu + là ai”.
- Góp phần vào đánh giá EEAT, đặc biệt với các site YMYL (Your Money Your Life).
- Thường nên index vì:
- Trang liên hệ (Contact):
- Thường nên index, đặc biệt với:
- Doanh nghiệp địa phương (local business).
- Thương hiệu có nhu cầu khách hàng tìm thông tin liên hệ trực tiếp từ Google.
- Có thể rank cho:
- “tên thương hiệu + liên hệ”.
- “tên thương hiệu + số điện thoại”, “tên thương hiệu + địa chỉ”.
- Thường nên index, đặc biệt với:
- Trang chính sách (Privacy Policy, Terms, Cookie Policy):
- Thường có thể index hoặc noindex đều được:
- Không phải landing page chính cho search intent thông thường.
- Ít khi là nguồn traffic organic có giá trị chuyển đổi cao.
- Nhiều website để index mà không gặp vấn đề SEO:
- Google hiểu đây là trang pháp lý, ít ảnh hưởng đến chất lượng nội dung chính.
- Một số website noindex để:
- Giữ chỉ mục gọn hơn, tập trung vào các trang có giá trị tìm kiếm cao.
- Giảm số lượng URL “noise” trong báo cáo GSC.
- Thường có thể index hoặc noindex đều được:
Thực hành phổ biến trên website chuẩn SEO:
- Giữ index cho:
- Trang giới thiệu.
- Trang liên hệ.
- Các trang thể hiện năng lực, đội ngũ, chứng chỉ, case study, review khách hàng.
- Cân nhắc noindex cho:
- Trang chính sách ít liên quan đến search intent, nếu muốn giữ chỉ mục tập trung.
- Các trang pháp lý phụ, điều khoản chi tiết không cần xuất hiện trên SERP.
Quan trọng là đảm bảo các trang này dễ truy cập từ menu, footer, breadcrumb và được trình bày rõ ràng, vì chúng góp phần quan trọng vào việc xây dựng niềm tin, minh bạch thông tin và đáp ứng kỳ vọng của cả người dùng lẫn công cụ tìm kiếm.

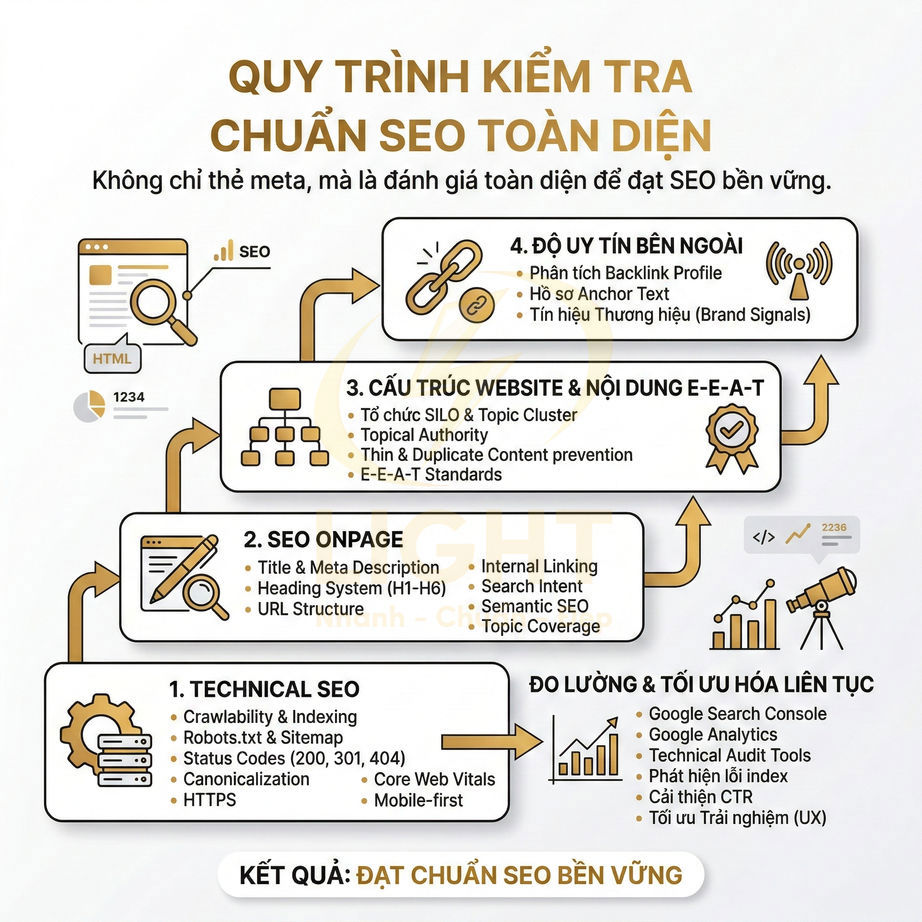
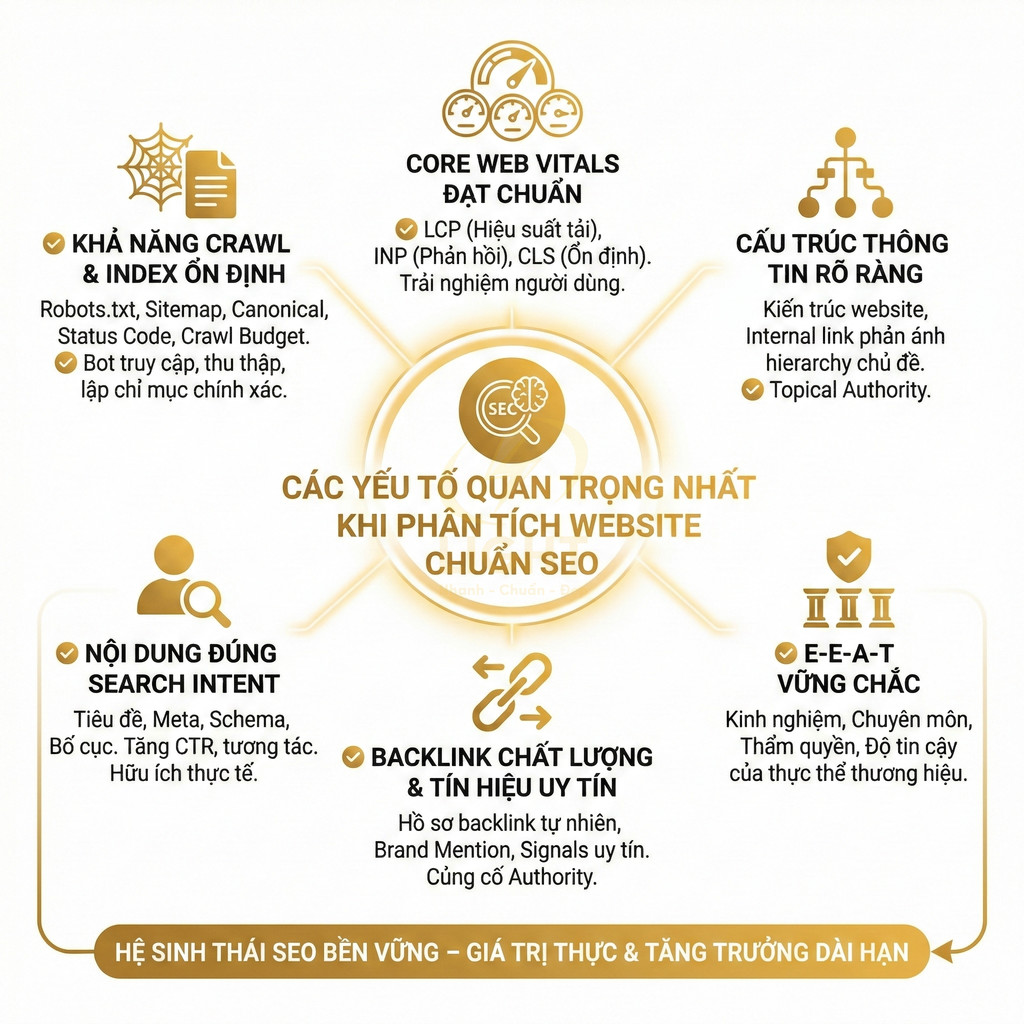
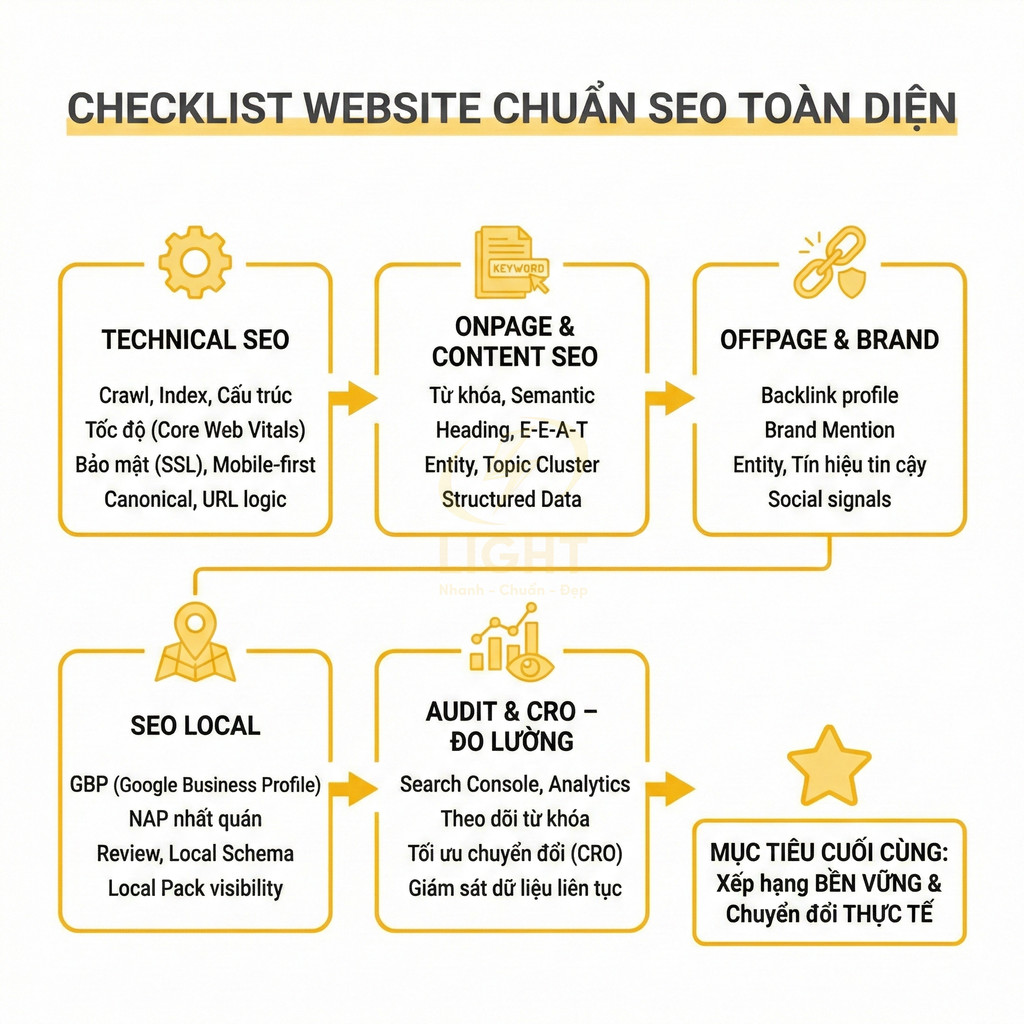
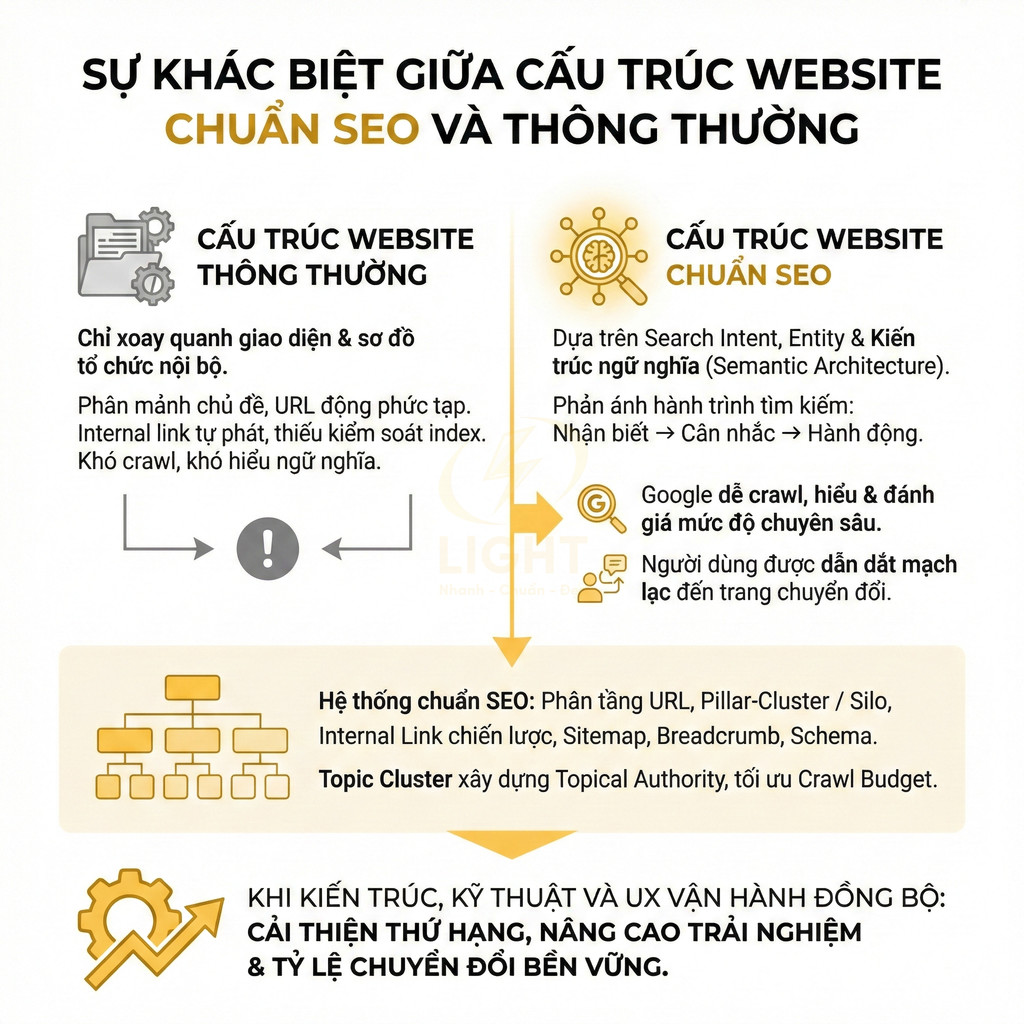
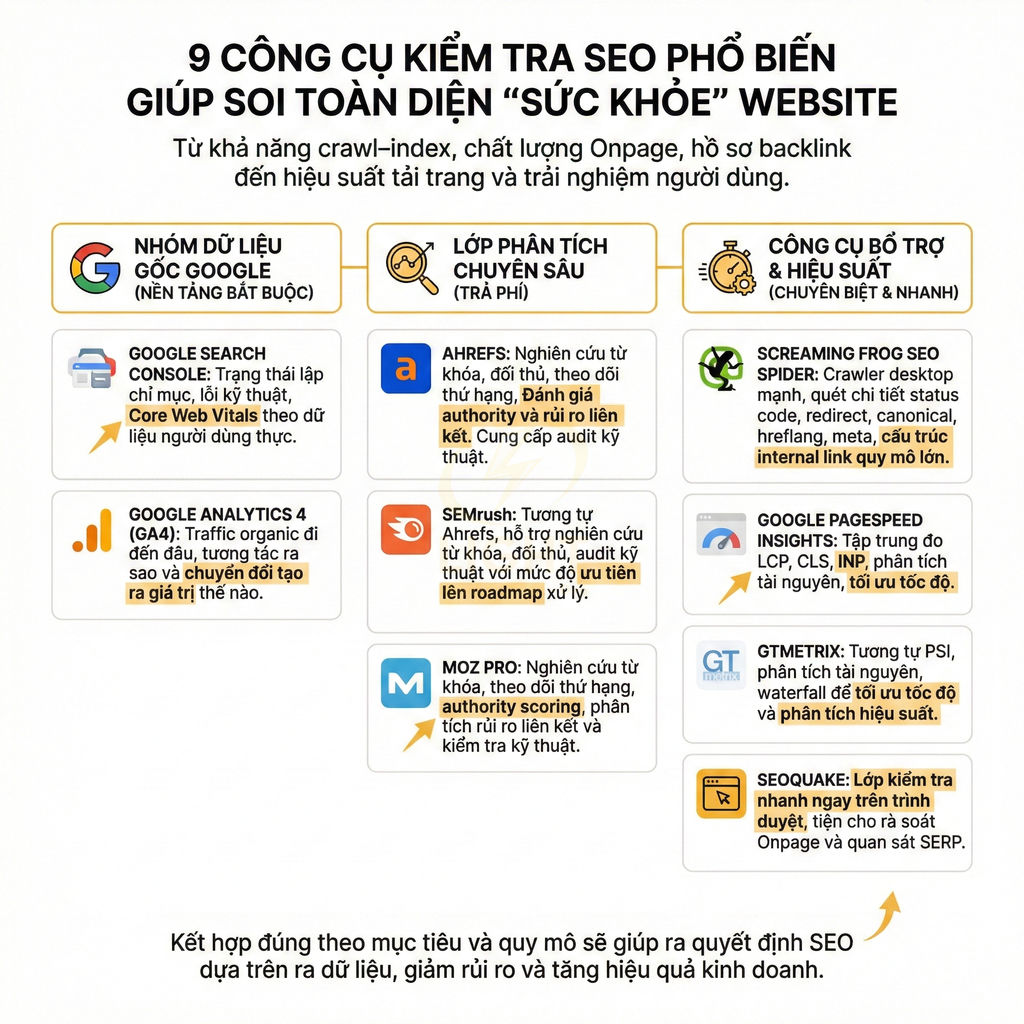
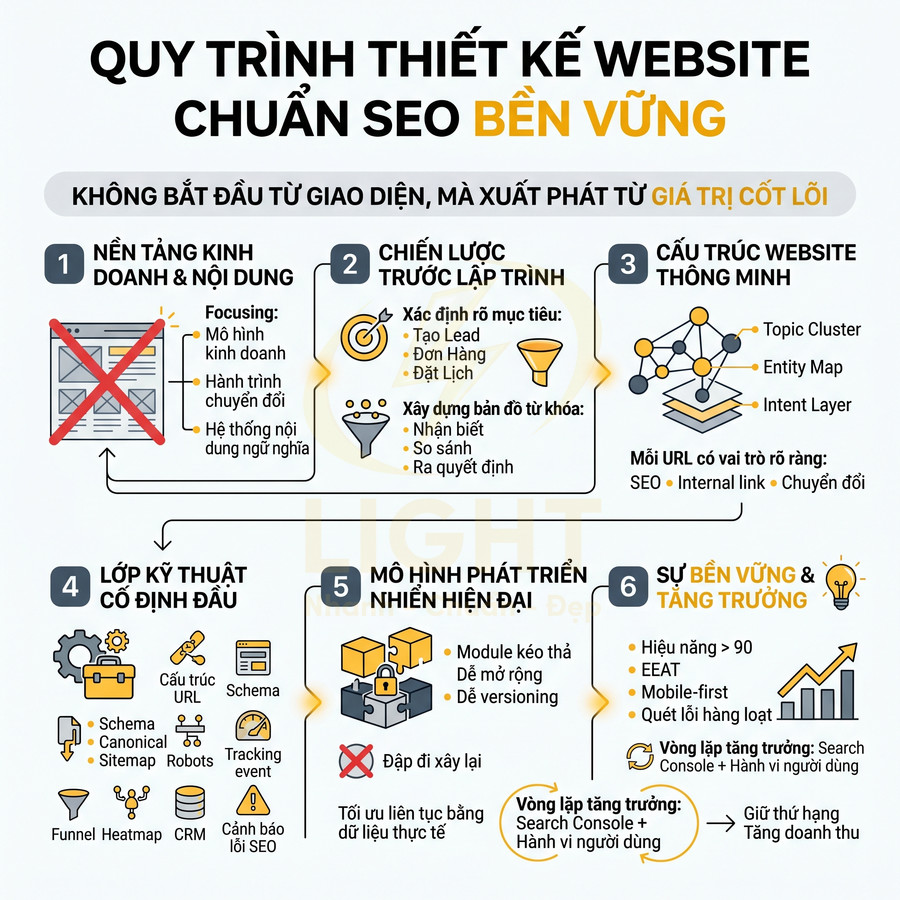
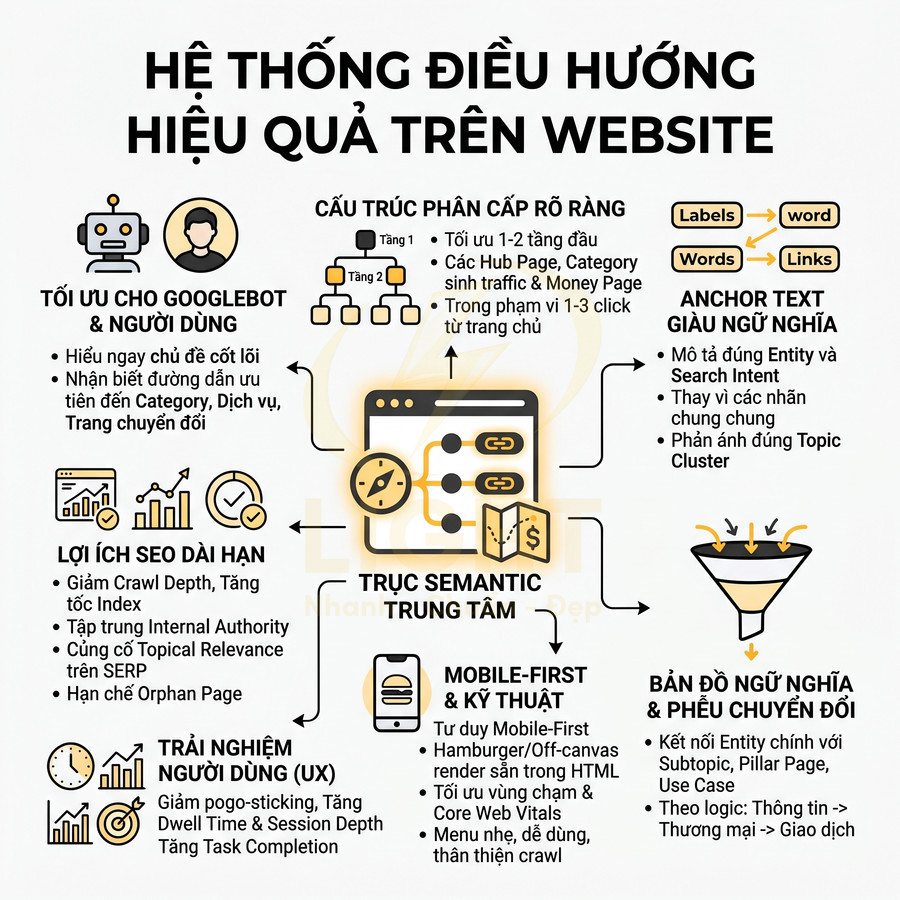
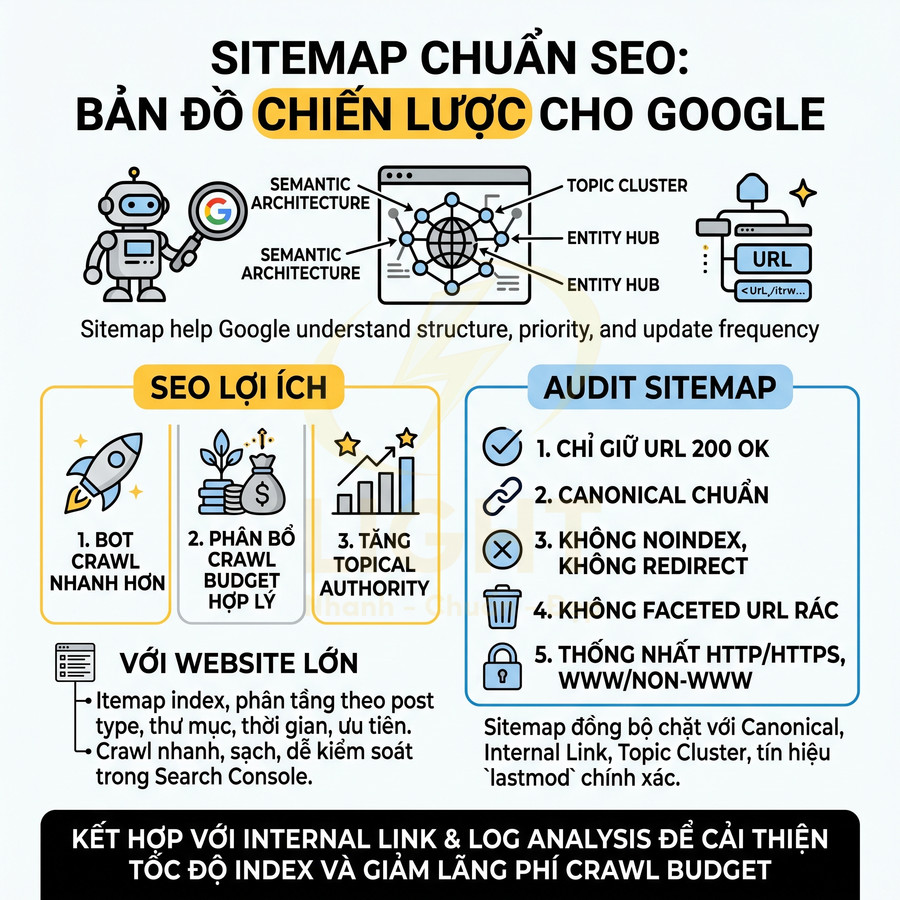
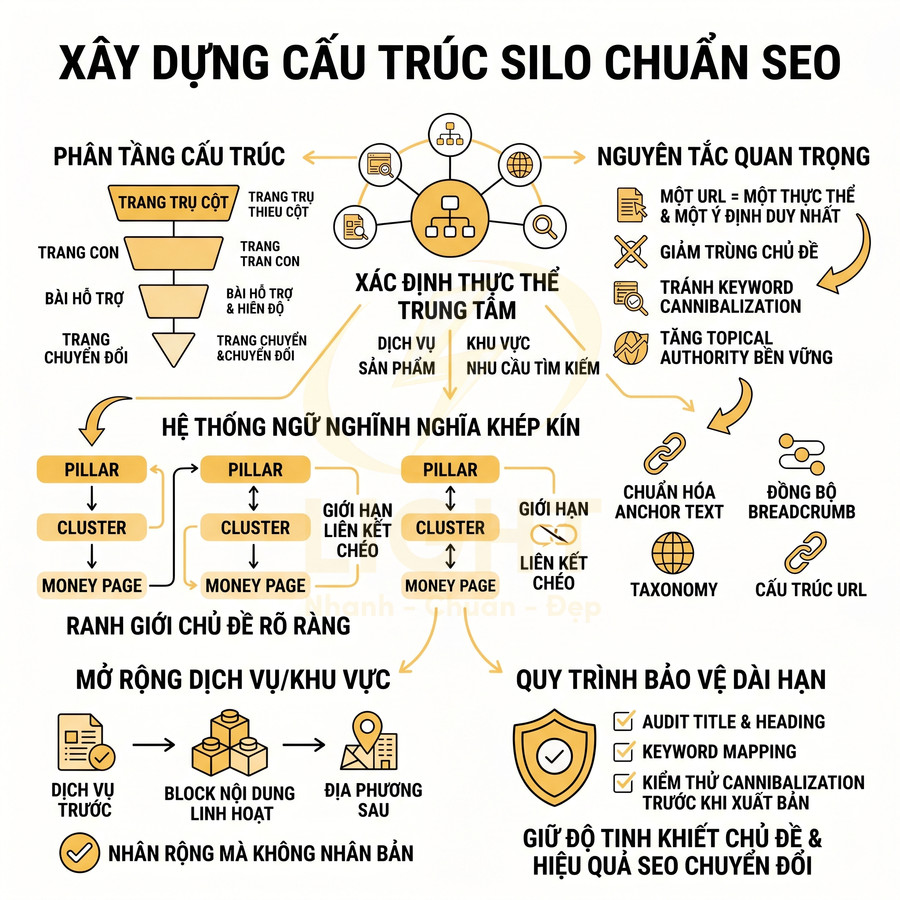
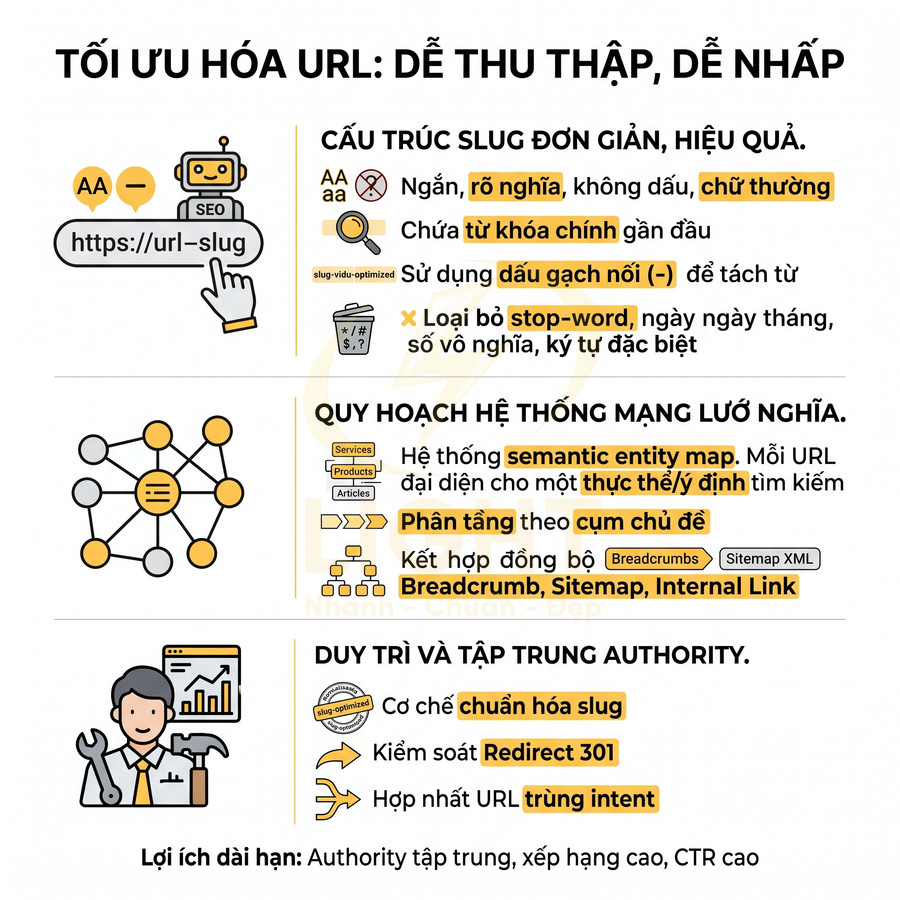
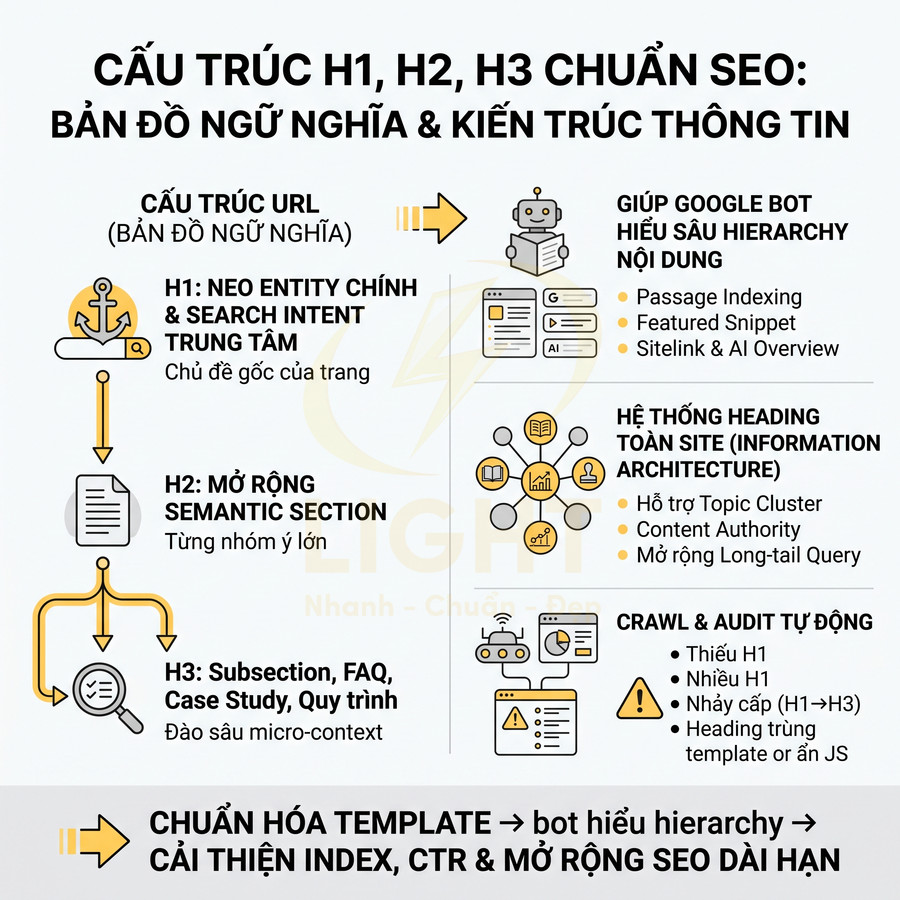
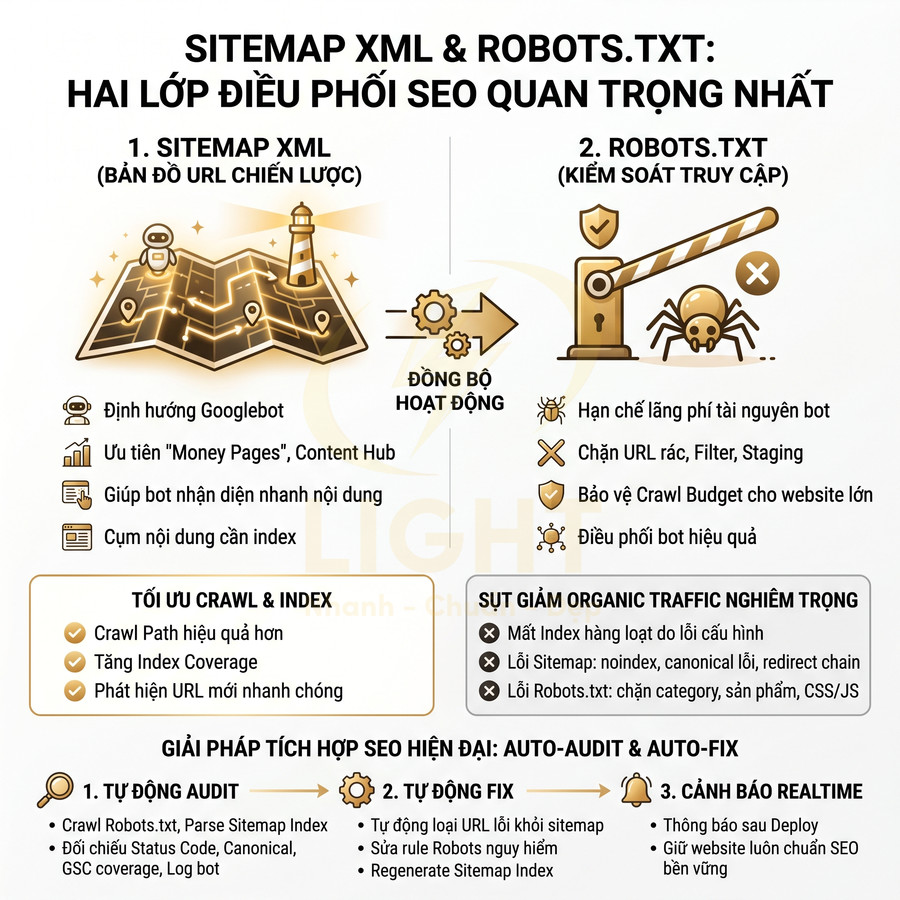
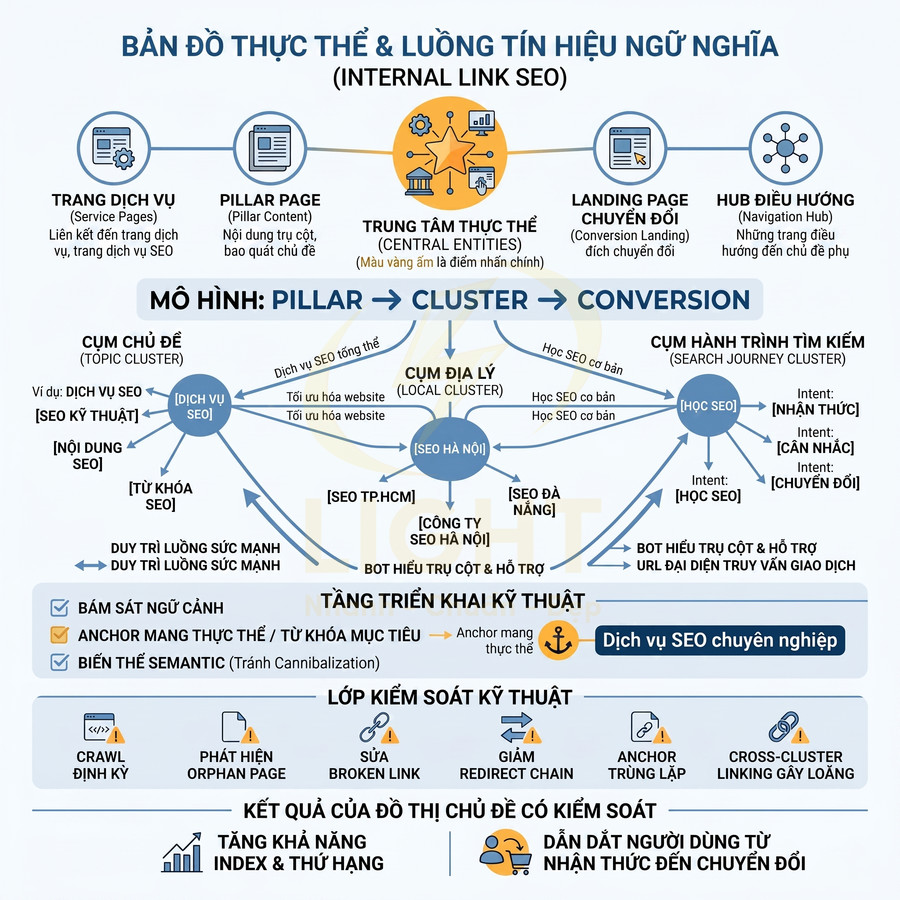
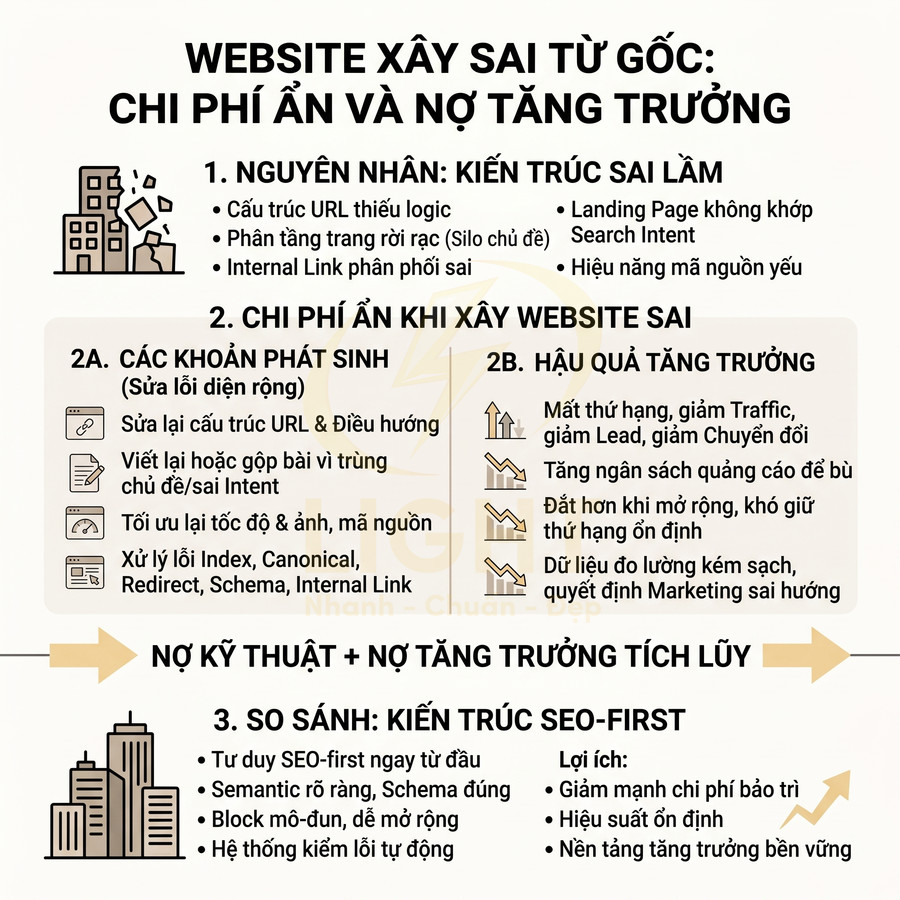
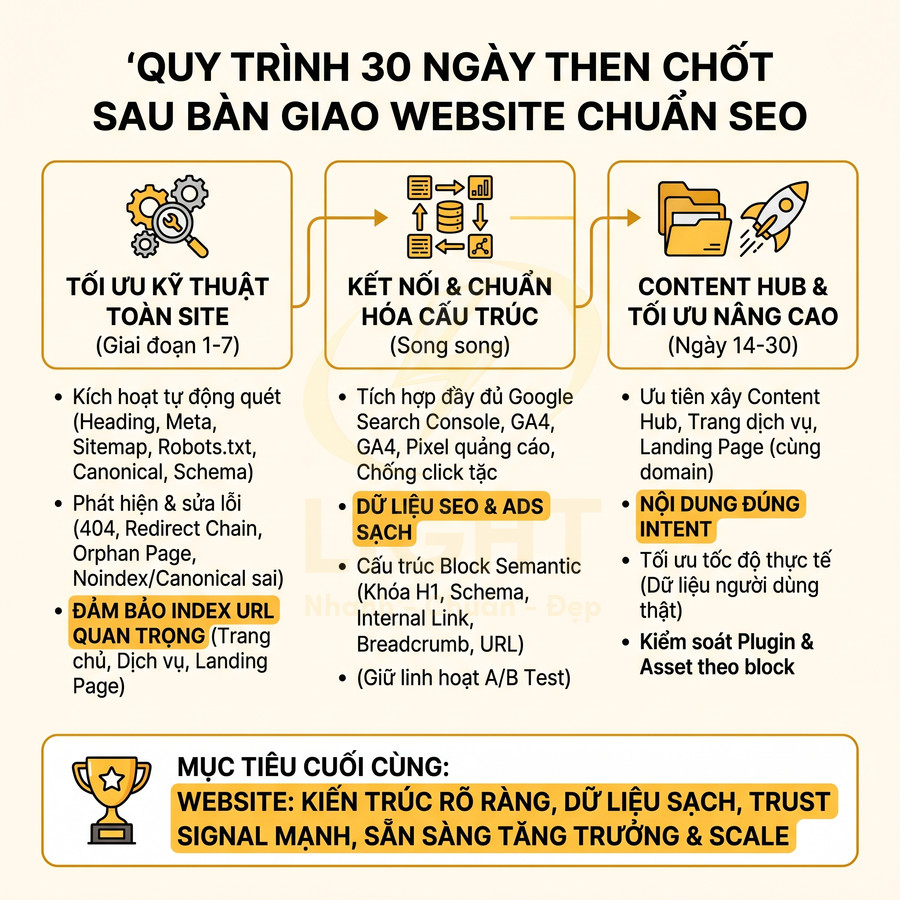
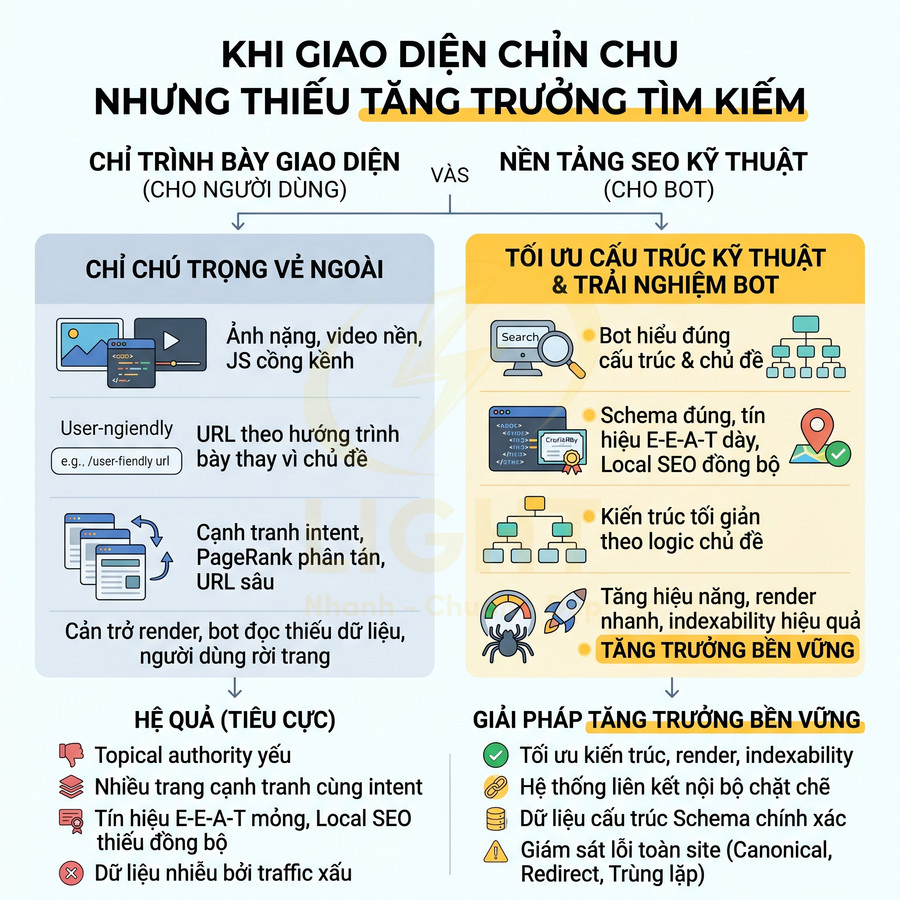
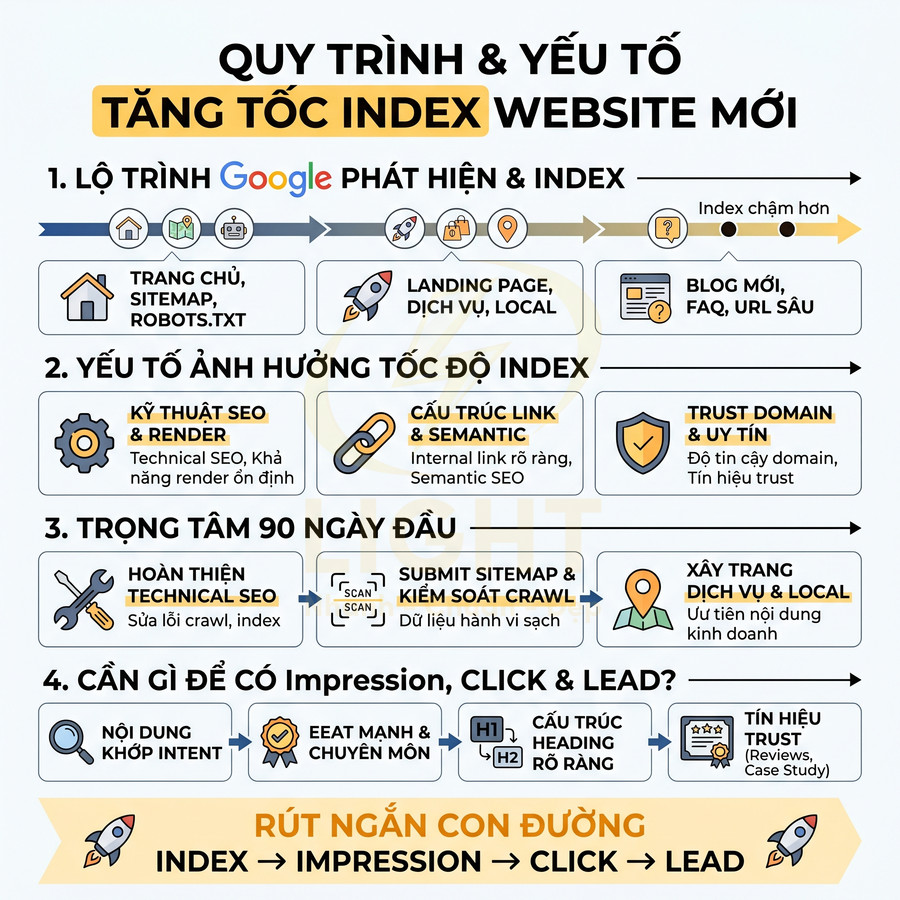
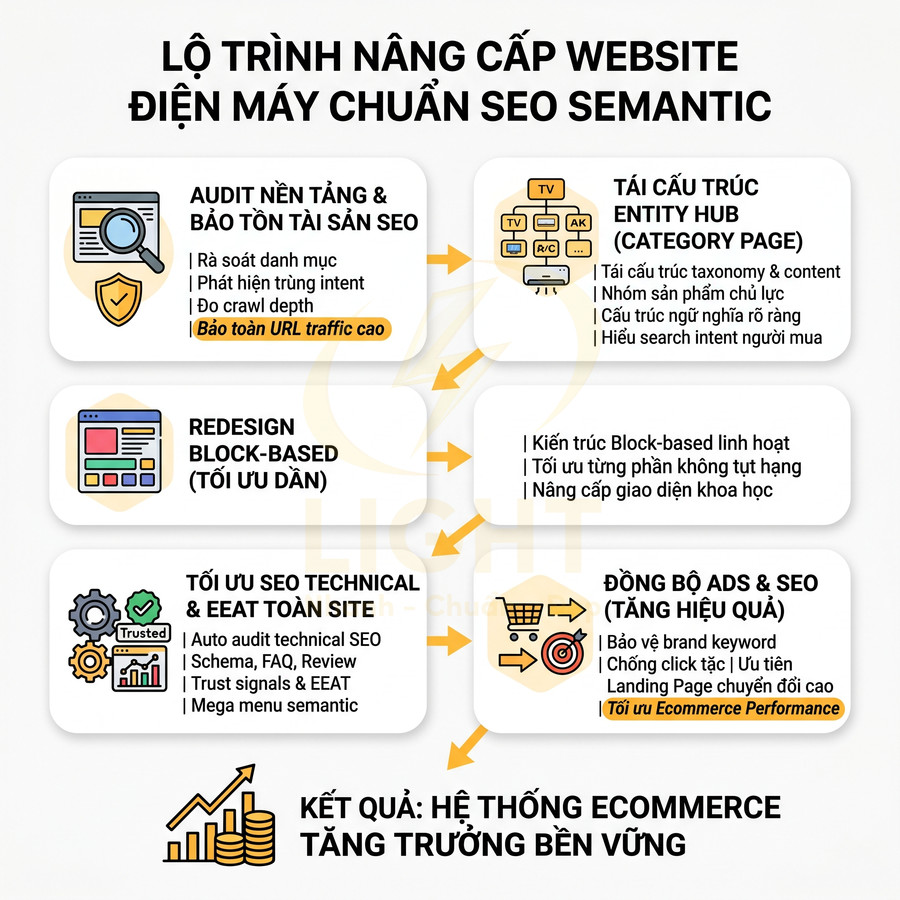
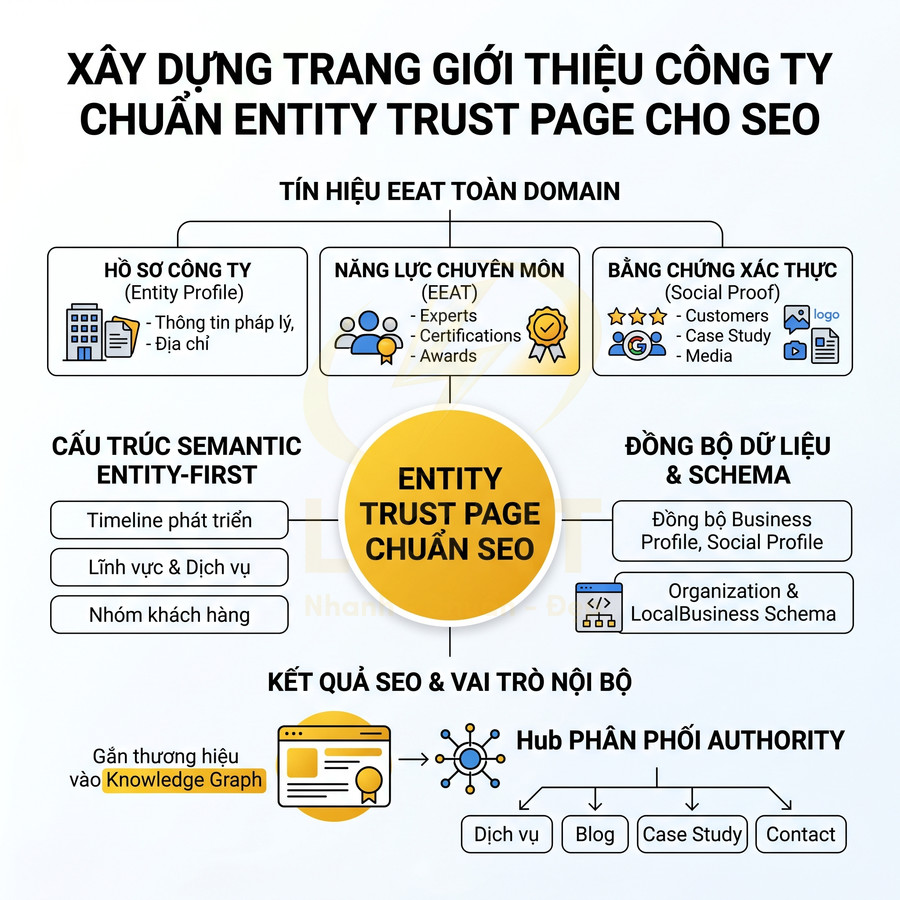
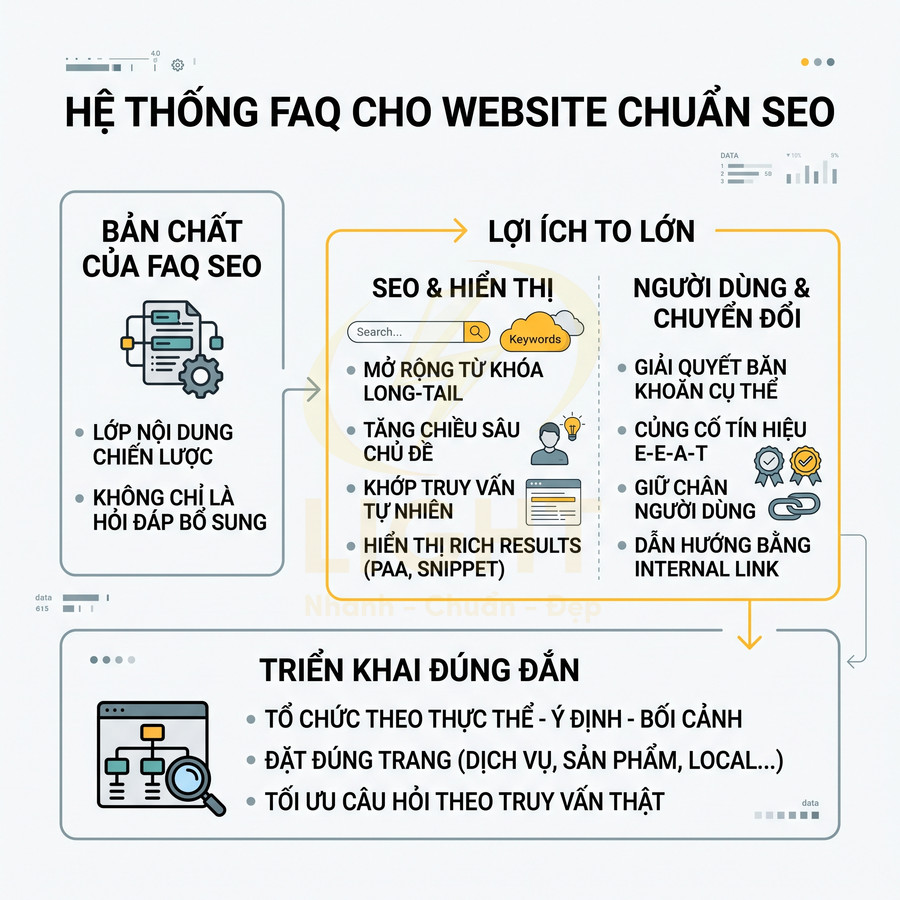
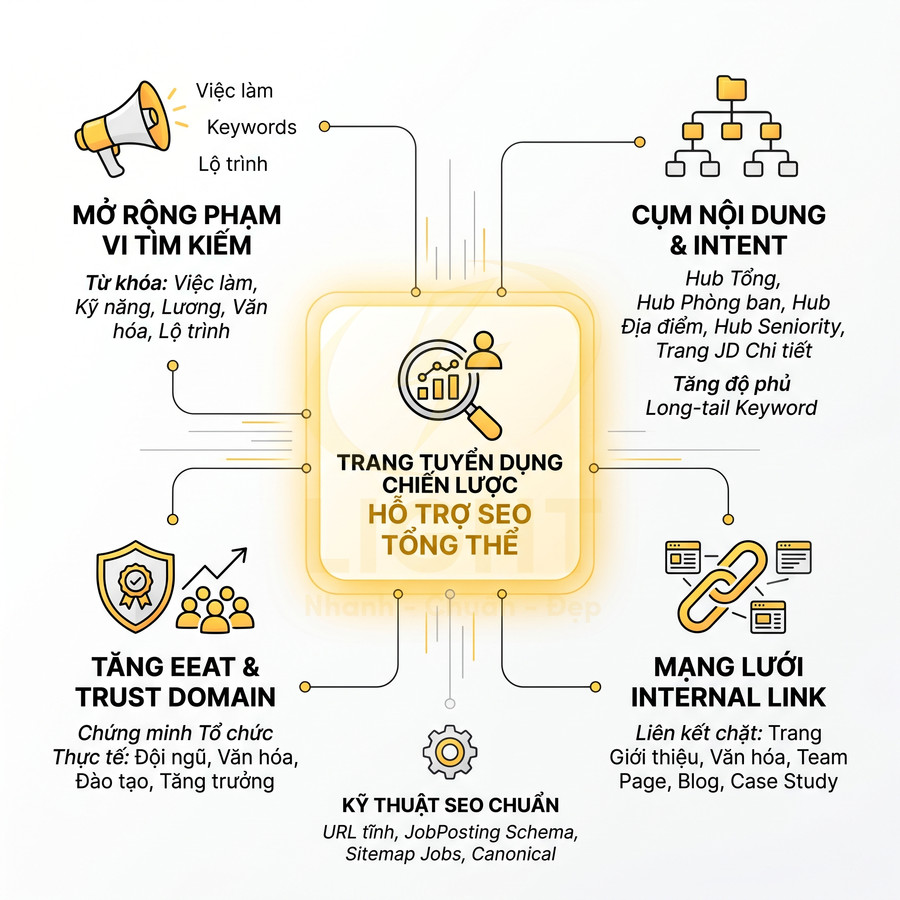
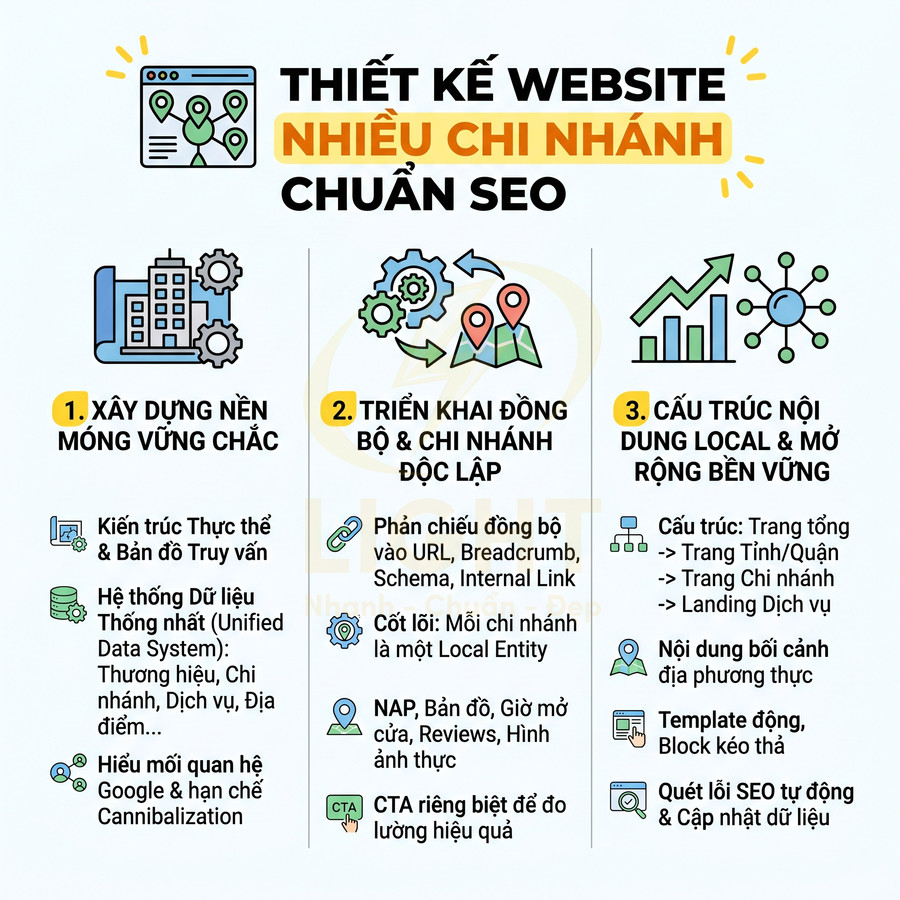
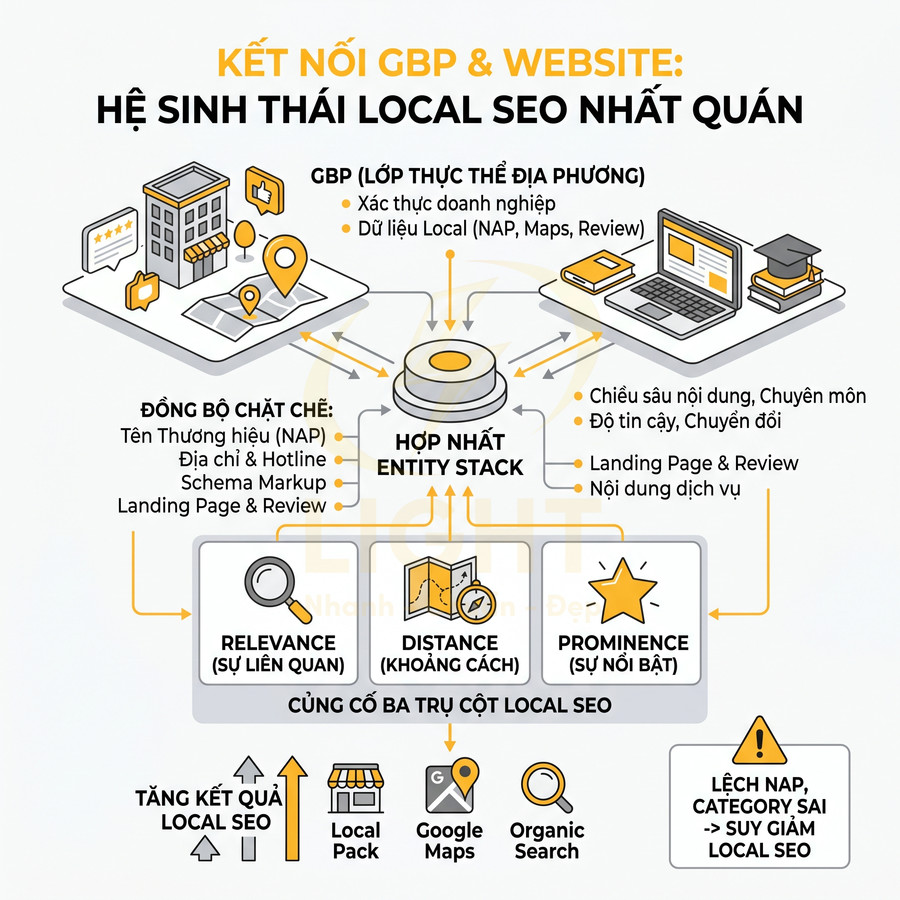
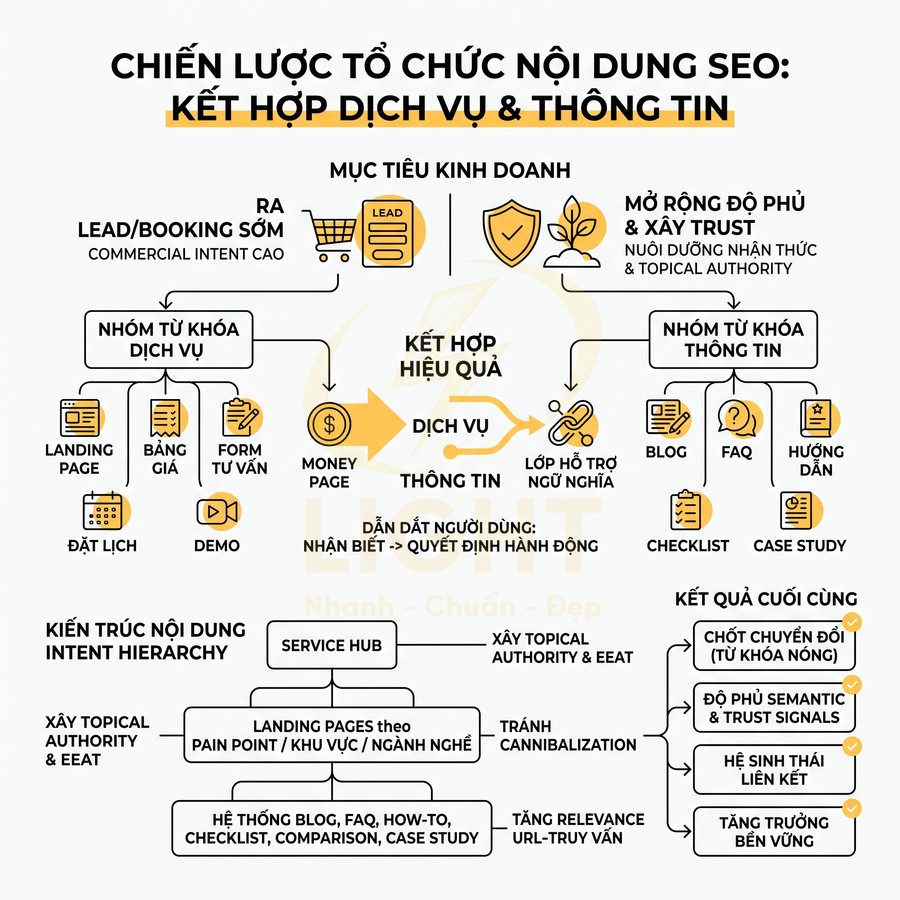
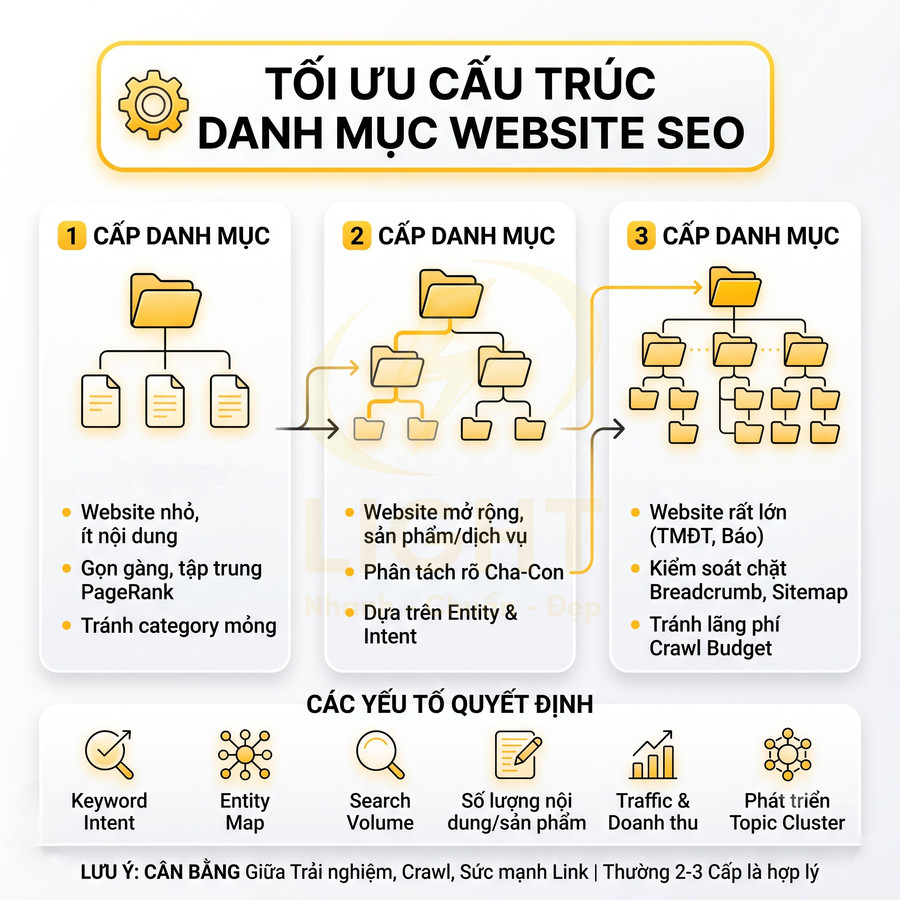
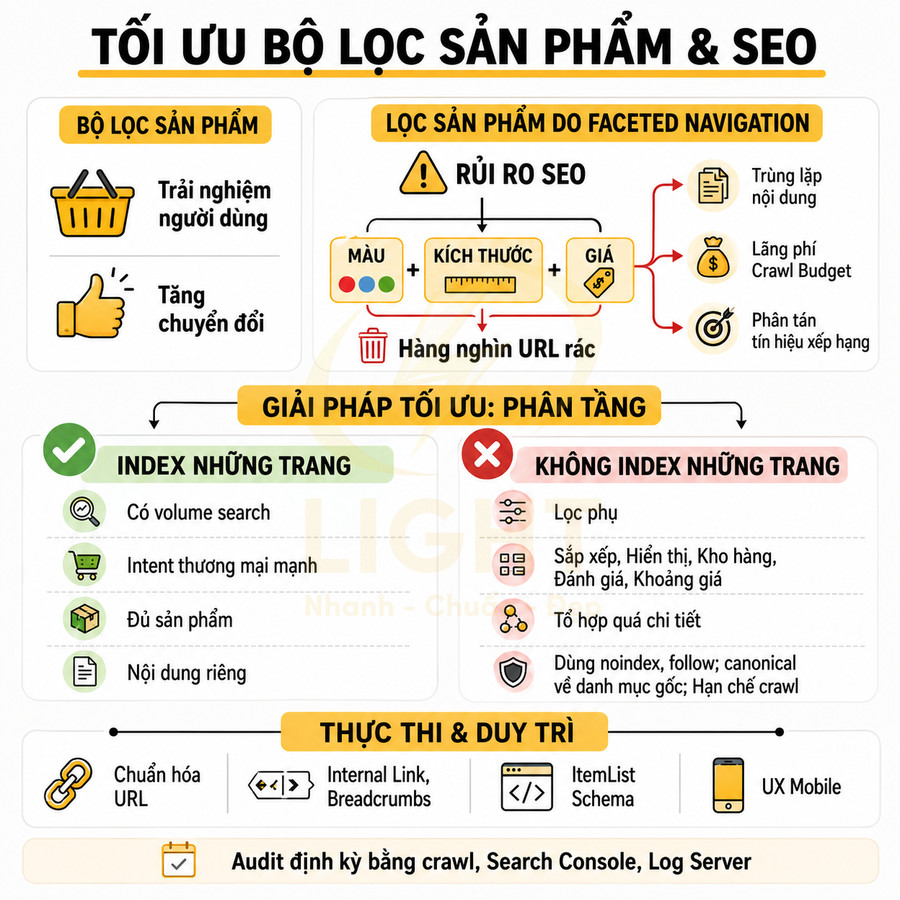
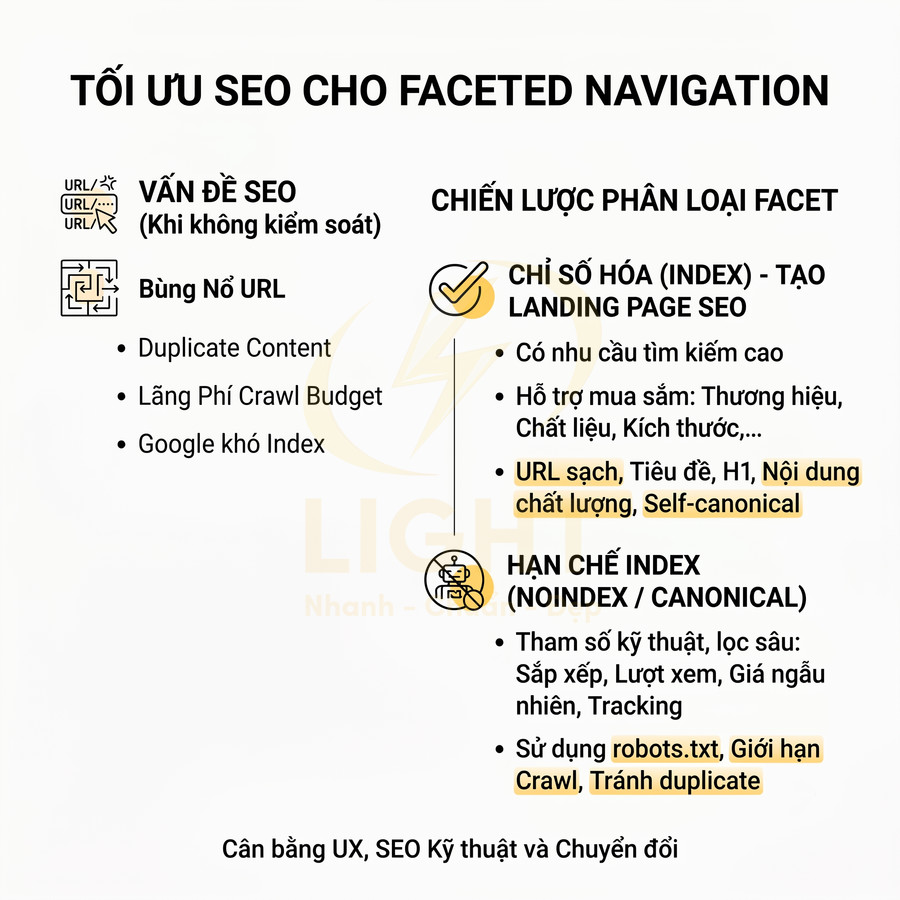
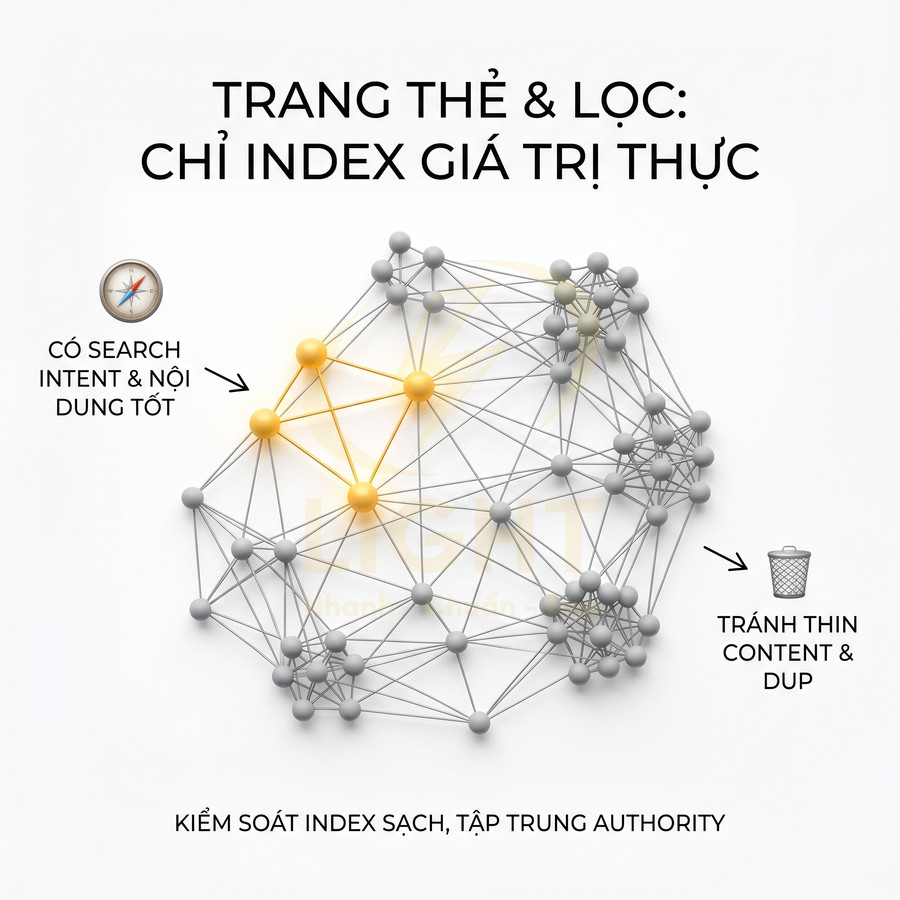
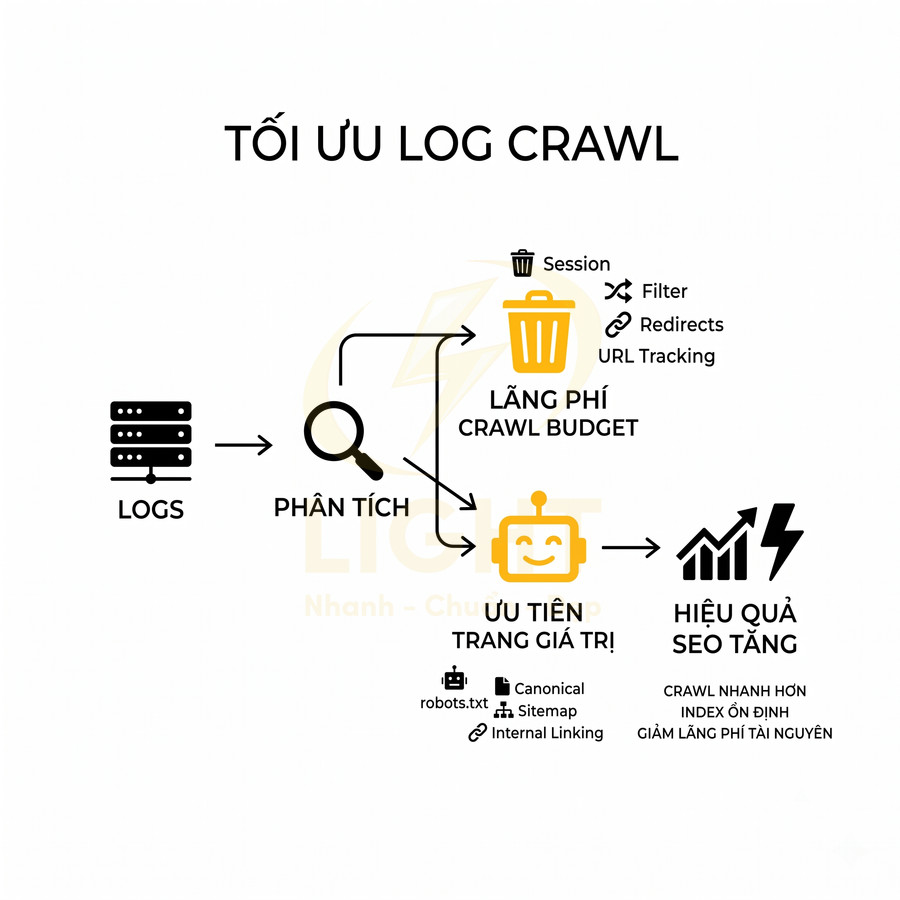
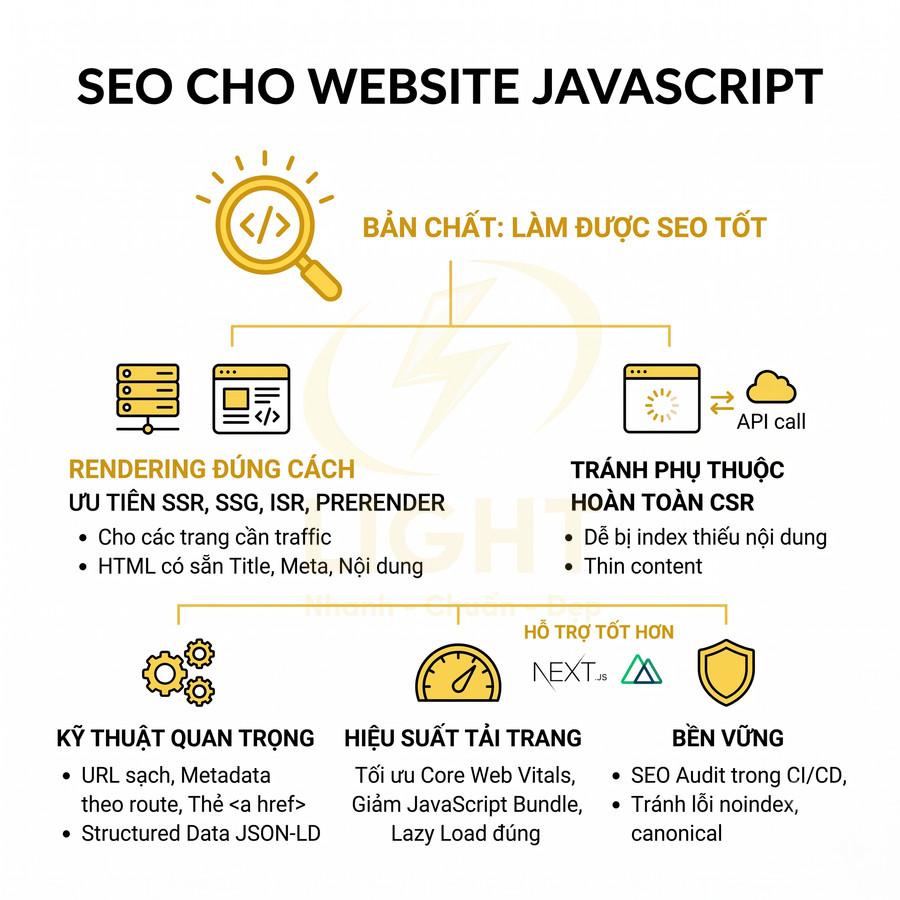
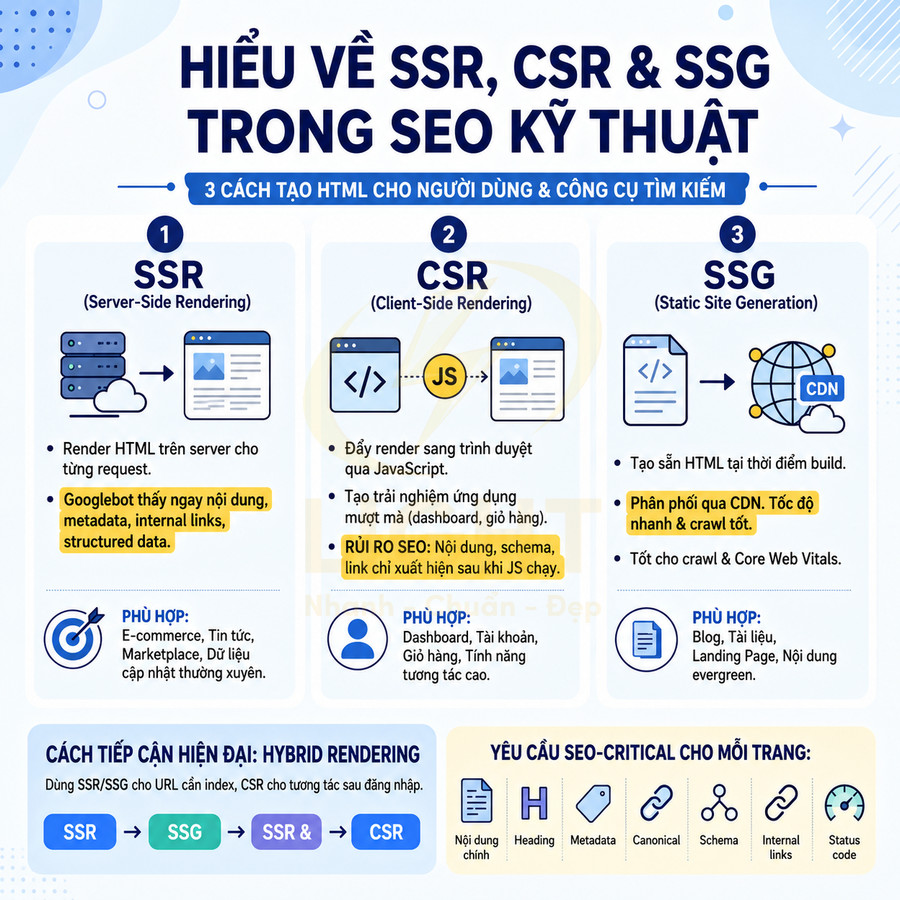

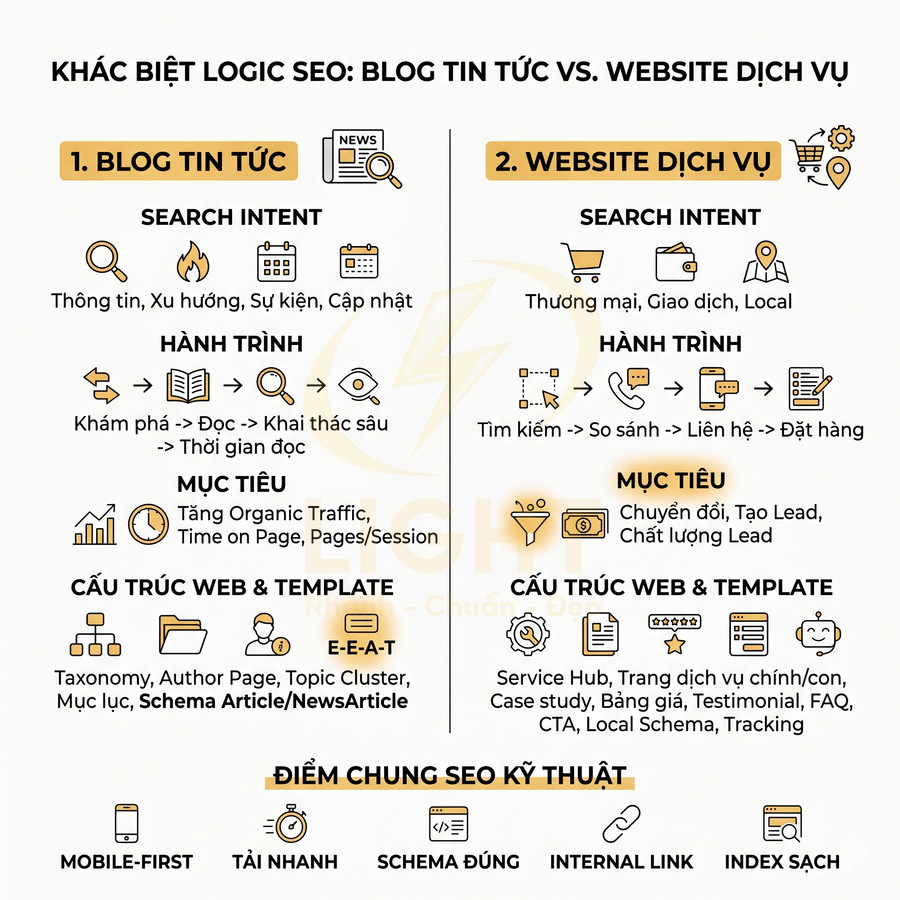
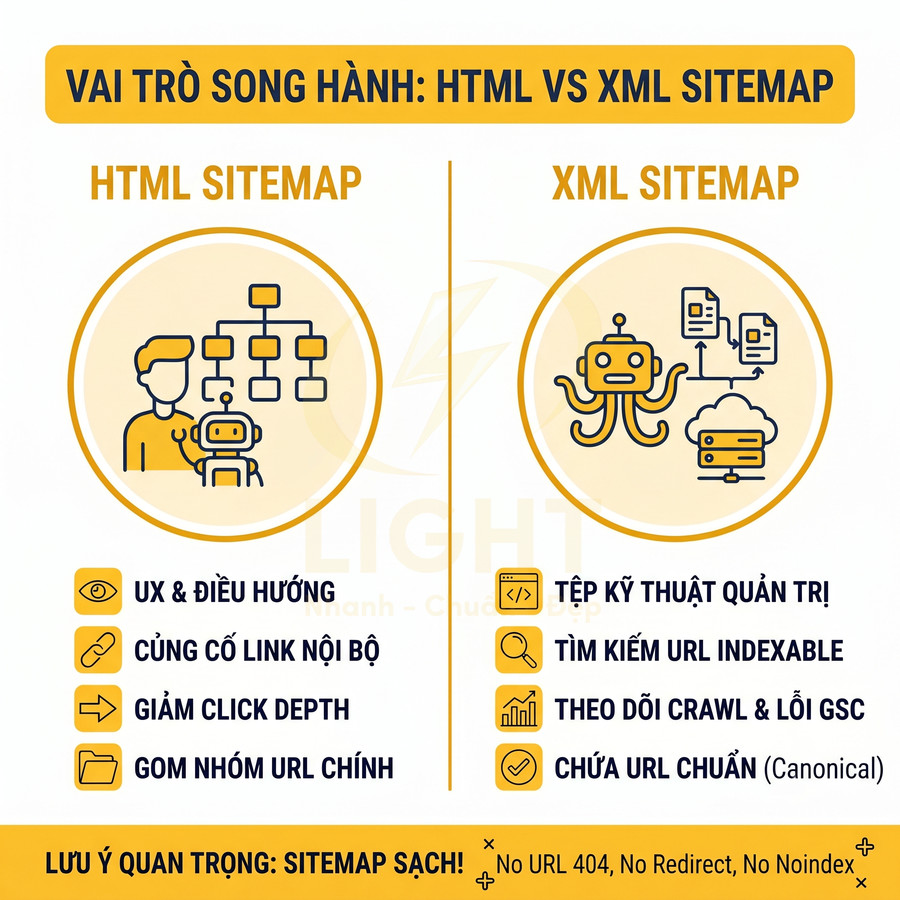
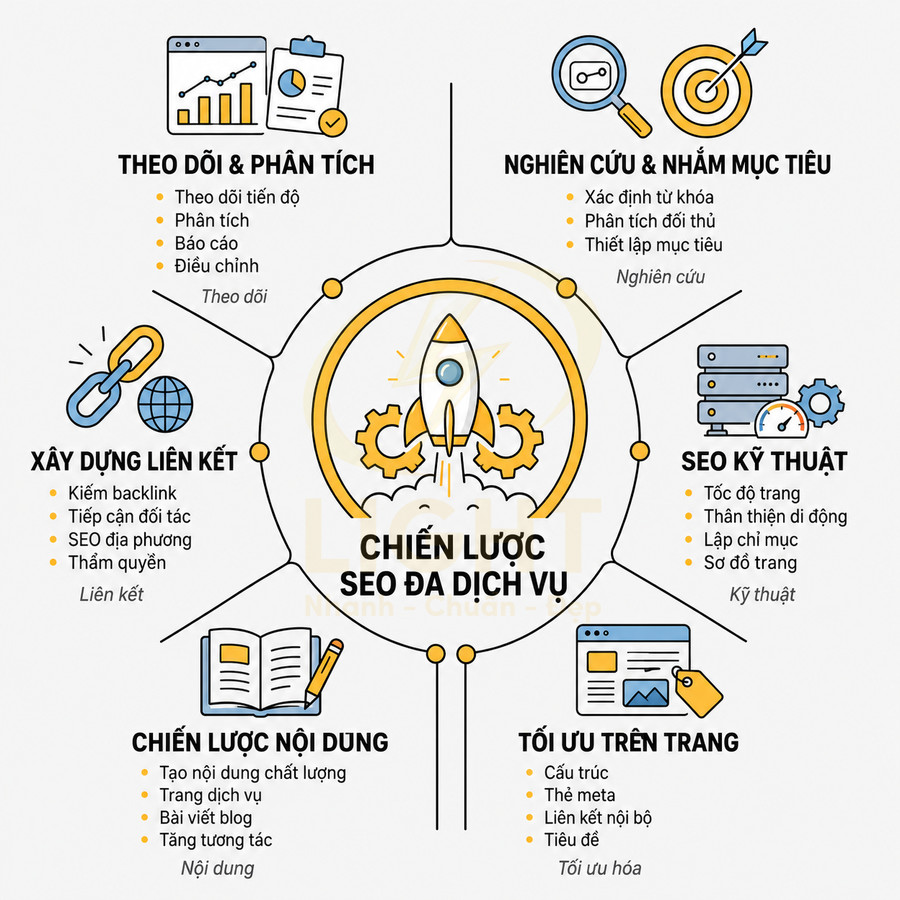
Chi tiết: https://light.com.vn/minh-hm
Youtube: https://www.youtube.com/@minhhmchanel2340